Еталон від старої моделі блокував пошук кращої
Property Finder, платформа нерухомості в регіоні MENA, щодня оцінює десятки тисяч фото оголошень за 11 атрибутами: водяні знаки, тип кімнати, якість знімка. Компанія шукала дешевшу модель на Amazon Bedrock і виявила, що 96,8% еталонних міток у тестовому наборі скопійовано з прогнозів моделі, яка вже працює. Тож будь-яка альтернатива програвала ще до перевірки.
Експерт заново вручну розмітив 356 фото з ОАЕ. На 256 із них базова модель мала Micro F1 0,55, а Llama 4 Maverick — 0,75. Модель, обрана в підсумку, за даними авторів, точніша й на 86% дешевша.
Чому еталон від чинної моделі — пастка
Найпоширеніший спосіб зібрати тестовий набір такий: прогнати чинну модель і вважати її відповіді правильними. Модель працює, скарг немає, тож мітки здаються достатньо добрими. Але тоді будь-яку альтернативу оцінюють за схожістю з чинною моделлю, а не за правильністю. За словами авторів, порівняння втрачає сенс, коли ключ відповідей написала модель, яку ви хочете замінити.
У Property Finder, крім упередженості, знайшлися й прямі помилки. У розпізнаному тексті водяних знаків були помилки в окремих символах, зокрема вигадані назви брендів, і все це було позначено як правильне. Фото з кількома кімнатами примусово отримували одну мітку. У решті 3,2% міток, які ставили люди, з'явилися категорії поза специфікацією, наприклад «Офіс», якої в промпті не було.
Як зібрати чесний еталон: кроки
- Розмітка з нуля експертом, який знає галузь. Доступу до прогнозів чинної моделі в нього немає. У Property Finder це був фахівець зі стратегії й аналітики, який знає стандарти якості оголошень. Спірні випадки розбирали на окремих сесіях із командою AWS.
- Вибірка з нерозмічених робочих оголошень із репрезентативних сегментів.
- Кілька міток там, де зображення справді неоднозначне. Фото коридору, де у дверях видно спальню, — це і коридор, і спальня.
- Окрема частина для налаштування. Перші 256 фото пішли на налаштування промптів, ще 100 розмітили вже після цього.
- Кілька метрик. Основна — Micro F1. Поруч — Macro F1, бо Micro F1 визначають часті класи, і вона може приховати слабкий результат на рідкісних.
За оцінкою авторів, 356 фото приблизно достатньо, щоб помітити помірну різницю між моделями. На рідкісних класах менші відмінності можуть лишитися непоміченими.
Що дало налаштування промпту і що не спрацювало
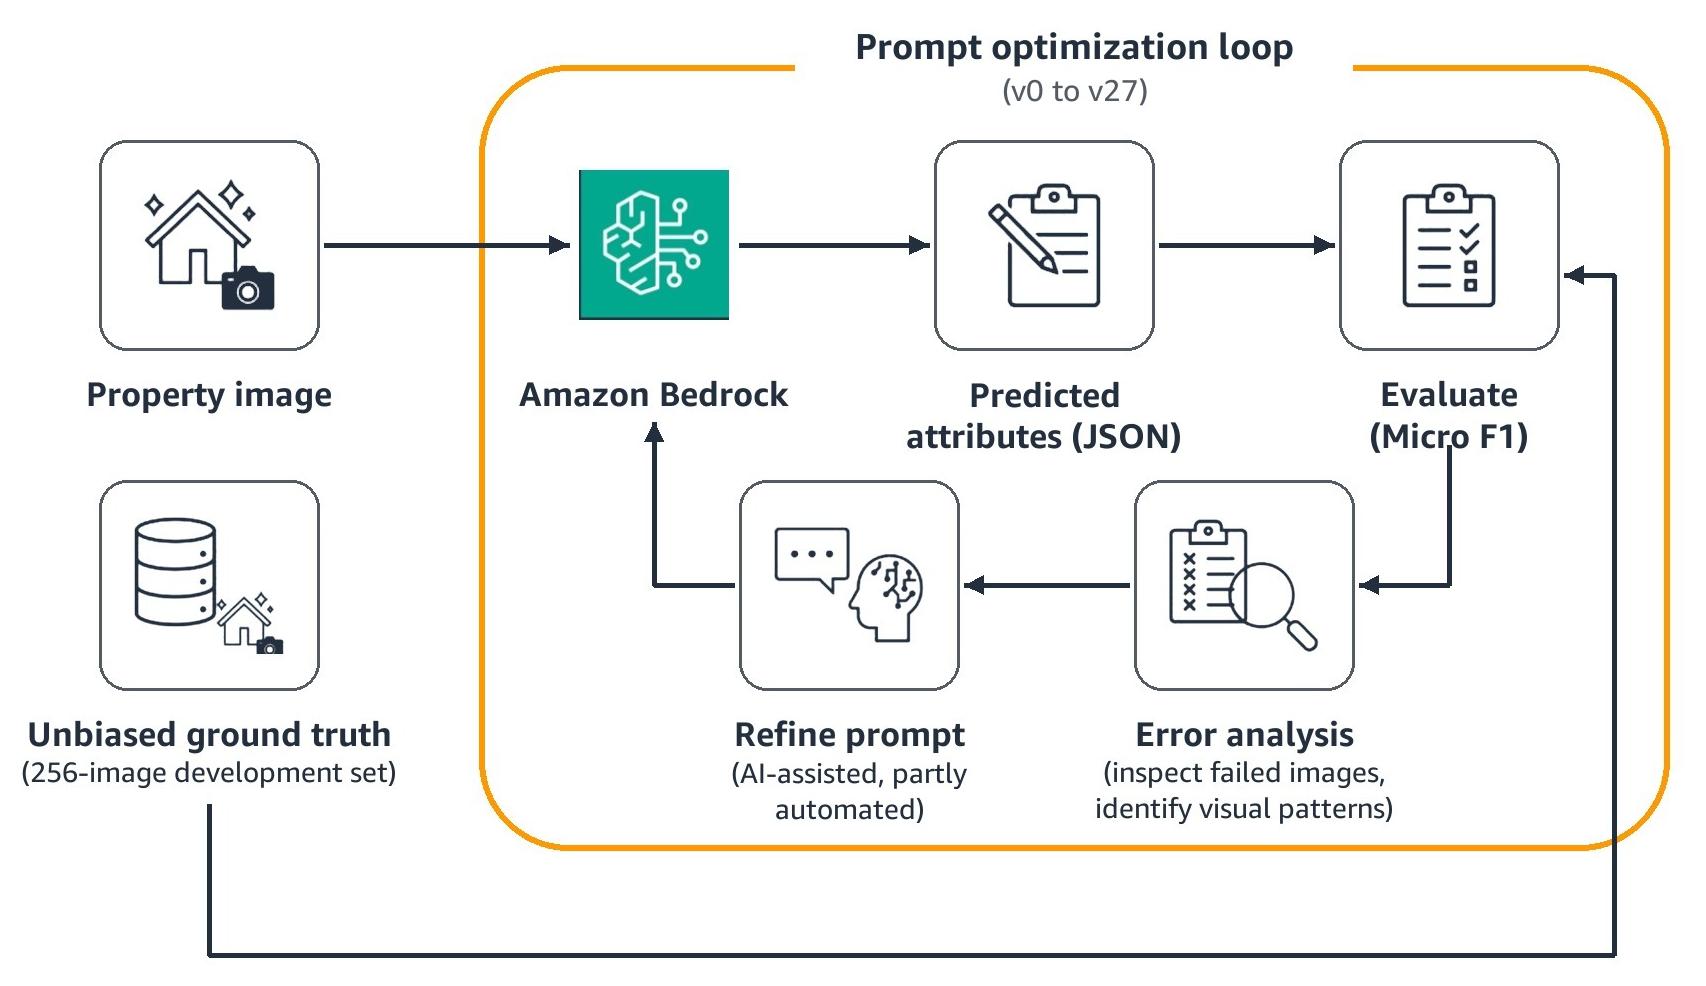
Цикл виглядав так: промпт → прогноз у JSON → оцінка Micro F1 → розбір фото з помилками → нова версія. Так пройшли версії від v0 до v27. Перший приклад: моделі визначали кімнату за тим, що видно у дверях. Додали правило класифікувати за кімнатою, яка займає більшу частину кадру. Пізніше дозволили кілька міток, і кімнату у дверях стали позначати додатковою міткою. Другий приклад: у деяких регіонах на фото є декоративні арабські написи, які не є водяними знаками. Окреме правило для них прибрало цілу категорію хибних спрацювань. Для Llama 4 Maverick саме налаштування промпту підняло Micro F1 з 0,75 до 0,81 на наборі для налаштування.
Що не спрацювало. Водяні знаки й решту атрибутів спробували винести у два окремі виклики. Помітного приросту точності це не дало, а виявлення фото в рамках різко погіршилося: моделі плутали накладені водяні знаки з рамками. Загальні промпти без галузевих правил програвали на будь-якій моделі.
Що перевірити, перш ніж довіряти цифрам
- Підсумкові 0,80 проти 0,56 на 356 фото автори самі називають оптимістичними. Набір включає ті 256 фото, на яких налаштовували промпти обох моделей.
- Зусилля на налаштування були нерівні. Модель A мала один раунд (v22). Llama — кілька раундів (v24–v27) плюс правила Property Finder для рендерів, рамок і коридорів.
- 86% — оцінка станом на грудень 2025 року для регіону US East (Ohio). Для Llama це верхня оцінка. Порівнювали з попередньою конфігурацією на промпті v21, а точність — на v22, тож вартість може відрізнятися.
- Скорочення затримки на 40–60% — дані власного моніторингу Property Finder.
- Прогнози не мають відкаліброваної впевненості. Як сигнал для ручної перевірки автори пропонують розбіжність відповідей двох моделей. Другий прогін коштує грошей, тож можна почати з вибірки. Спершу варто перевірити на наборі для налаштування, як часто цей сигнал ловить справжні помилки.