Своя мала модель точніша й до 49 разів дешевша
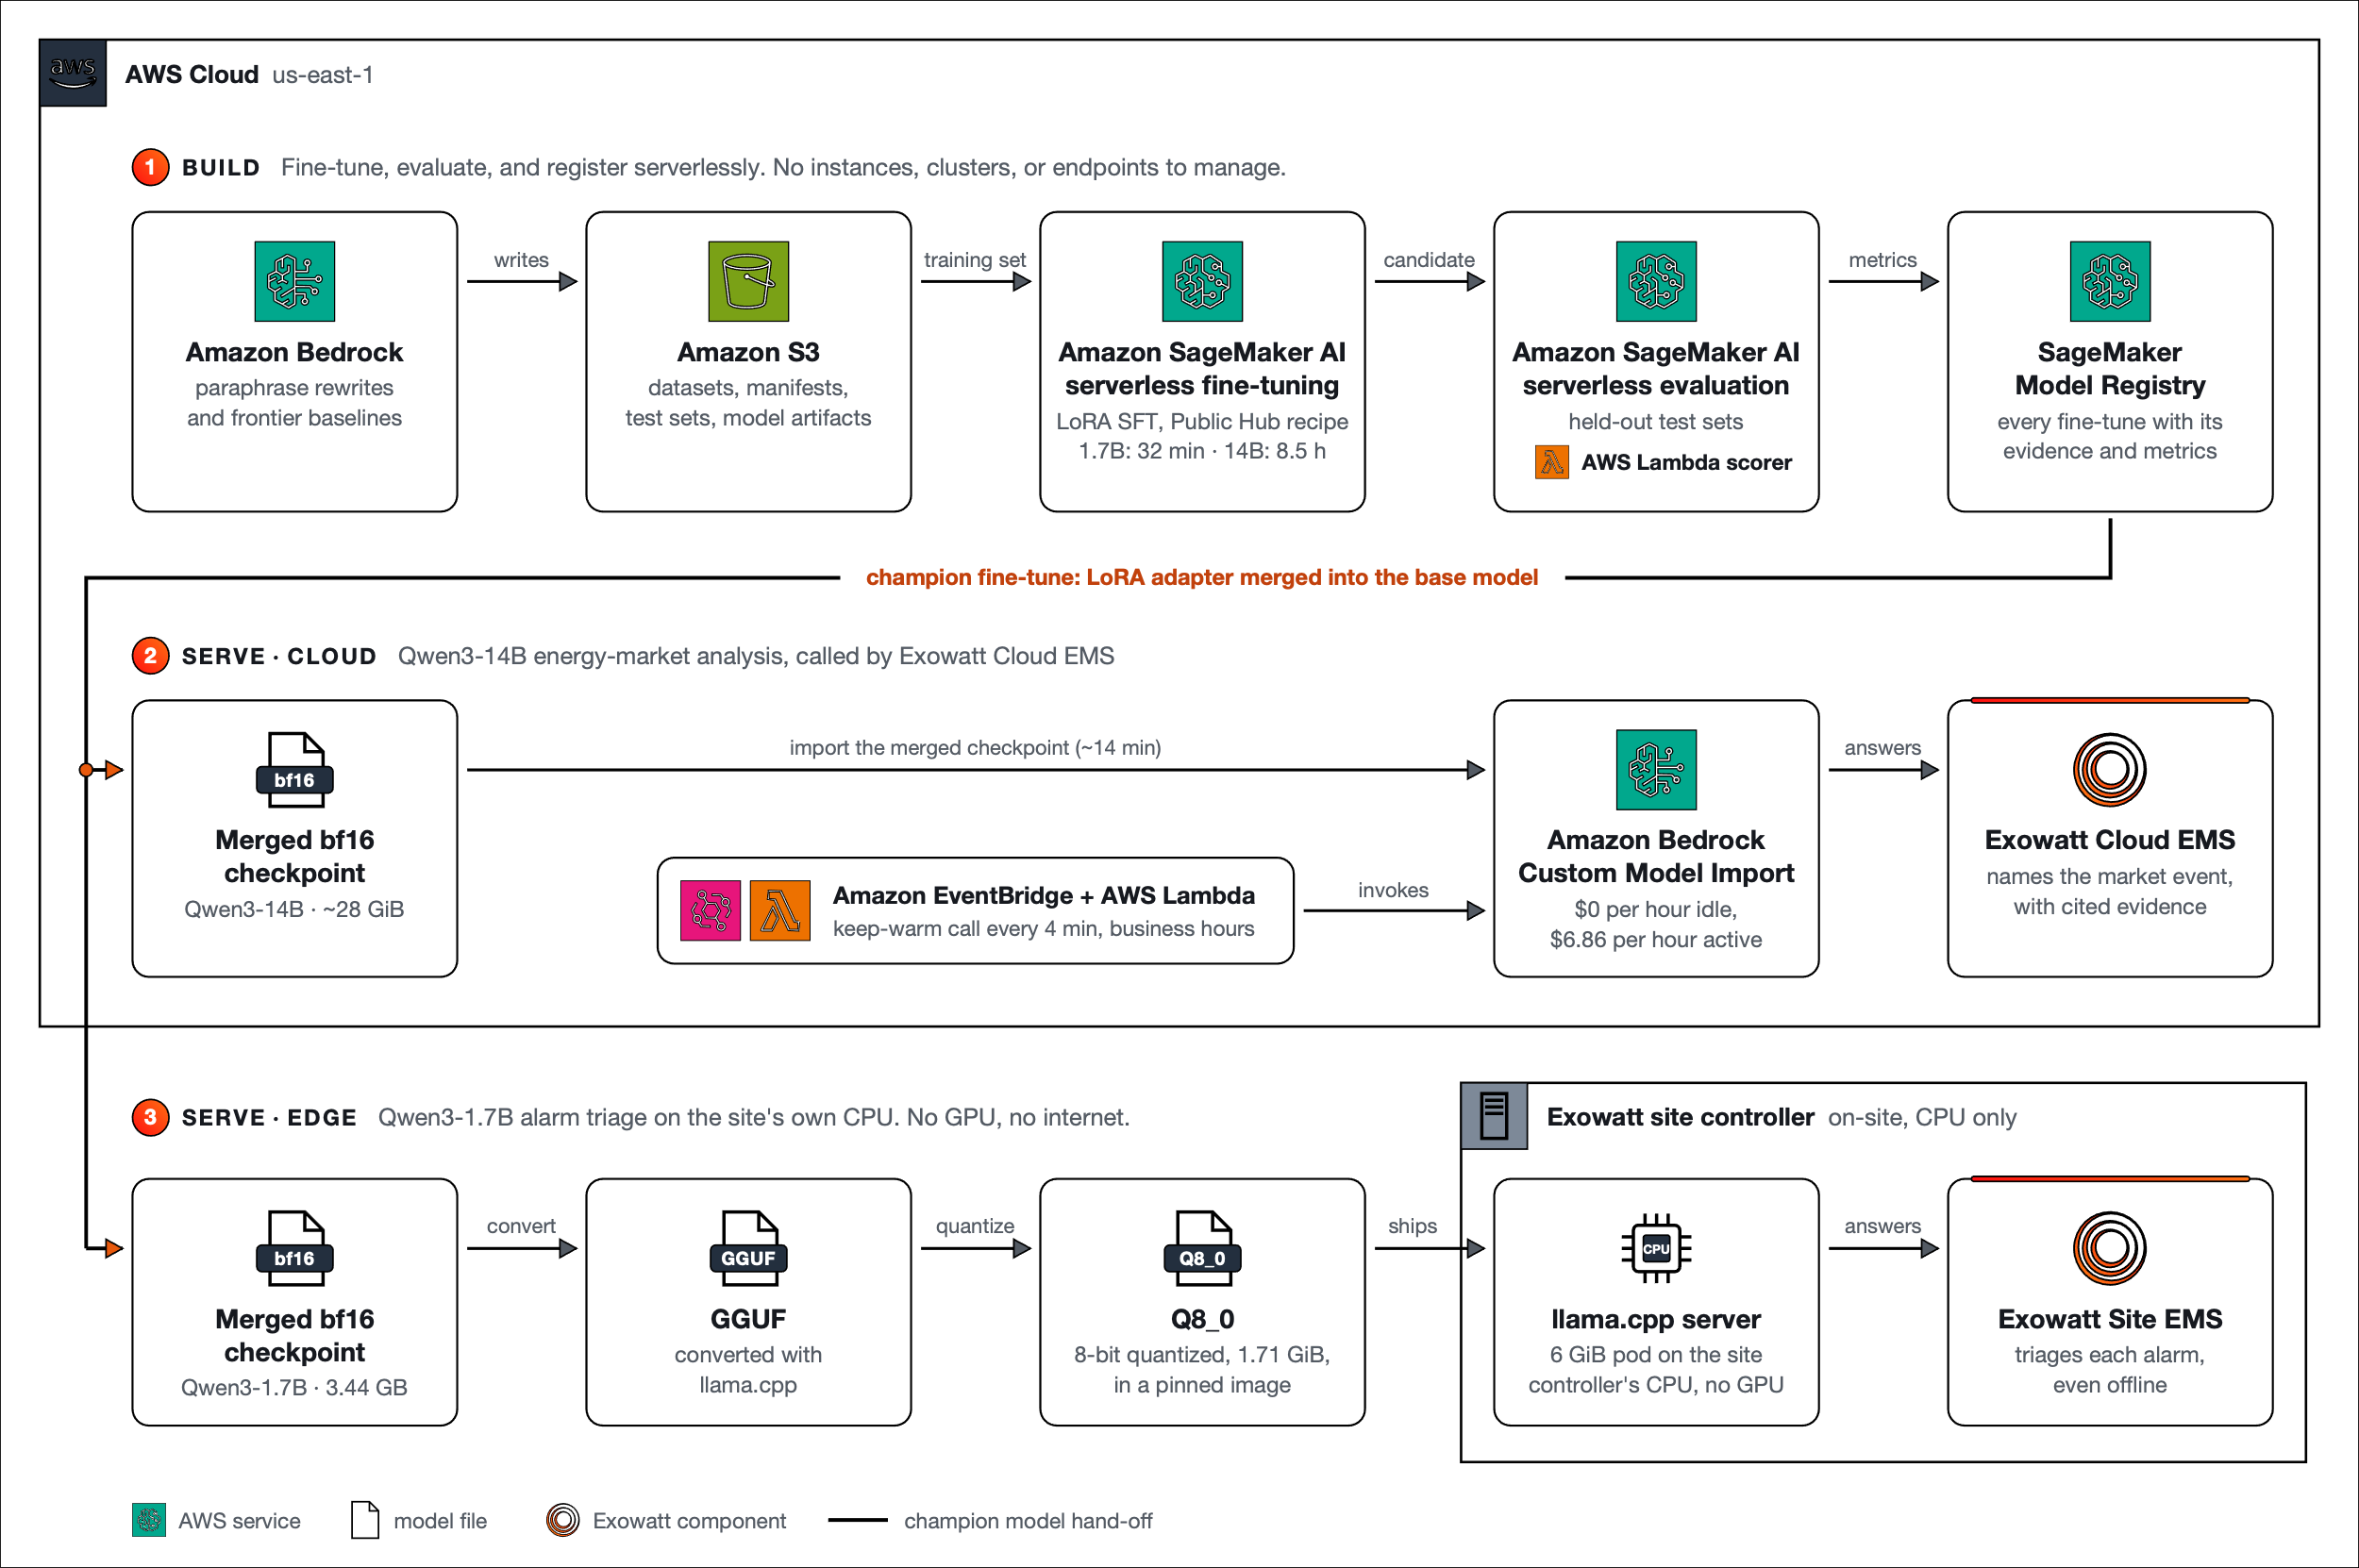
Exowatt (сонячні системи з тепловою батареєю P3 для дата-центрів AI) донавчила Qwen3-1.7B на Amazon SageMaker AI serverless model customization для тріажу аварій на об'єктах. Фронтир-модель не підходила: немає GPU й інтернету на майданчиках, а оплата запиту на тисячах об'єктів не масштабується. Тренування зайняло ~32 хвилини, коштувало $20–25 на 2522 прикладах і дало модель, яка перевершила Qwen3-8B з промптингом (0.735 macro-F1) при вп'ятеро менших параметрах, працюючи офлайн без GPU.
Другий кейс: аналіз енергоринку моделлю Qwen3-14B
Крім тріажу аварій на об'єктах, тим самим конвеєром Exowatt донавчила модель для хмарного аналізу енергоринку. Теплова батарея об'єкта постійно вирішує, скільки енергії тримати в запасі, а скільки віддавати в мережу — і для підключених до мережі майданчиків це залежить від ринкових умов. Модель читає шестигодинний пакет живих ринкових даних (близько 90 рядків цін у реальному часі, прогнозів на добу наперед і повідомлень енергосистеми) і за ~4 секунди визначає одну з п'яти ринкових подій, наприклад стрибок ціни, прив'язуючи кожне твердження до конкретного рядка даних.
Для завдання обрали Qwen3-14B: модель підтримується Amazon Bedrock Custom Model Import, має готовий рецепт LoRA в SageMaker Public Hub і важить близько 28 ГіБ. Базою для навчання стали публічні дані енергоринку Техасу (ERCOT) за п'ять років — близько 163 млн рядків у 12 таблицях. Команда розмітила їх правилами на 25 000 прикладів, а потім розширила тренувальний набір до 86 281 рядка, доручивши Claude Sonnet 4.6 на Amazon Bedrock переписати формулювання кожного прикладу зі збереженням меток і чисел.
Тренування — один LoRA-прохід, близько 8,5 годин серверлес-навчання, до чотирьох завдань одночасно; усього 23 завдання й ~155 годин за шість днів від плану до моделі в роботі. Додавання трьох перефразувань на відповідь підняло macro-F1 з 0,950 до 0,975; базова модель без донавчання давала лише 0,415. Готову модель імпортували в Bedrock Custom Model Import за ~14 хвилин, оплата $6,86 на годину лише під час активної роботи. Порівняно з Claude Opus 4.7 це +0,35 macro-F1 (95% довірчий інтервал 0,324–0,371) при приблизно 49-кратно нижчій вартості за 1000 відповідей: $0,60 проти $29,26.
Конвеєр з трьох етапів, який можна повторити
Exowatt побудувала не одну модель, а повторюваний процес для будь-якого вузького повторюваного завдання:
- Донавчання в хмарі: серверлес LoRA + SFT на SageMaker AI поверх відкритих моделей; найкращу модель реєструють у SageMaker AI Model Registry.
- Розгортання на об'єкті: модель заморожують, квантують у GGUF і запускають через llama.cpp у подах Kubernetes на контролерах об'єкта — без GPU й без інтернету.
- Розгортання в хмарі: обслуговування через Amazon Bedrock Custom Model Import, оплата лише за час активної роботи.
Донавчання на виділених GPU вимагає вибрати тип інстансу, дочекатись потужності й платити за весь час її утримання, включно з простоями. Серверлес-підхід рахує лише фактичний час навчання, тому в Exowatt донавчання стало рутинною щоденною операцією, а не рідкісною спланованою подією.
Типова помилка: більша модель і більше даних — не завжди краще
Перш ніж дійти до робочого рішення для тріажу аварій, команда спробувала Qwen3-8B з промптингом і захисними правилами — результат зупинився нижче цілі (0,735 macro-F1). Тринадцять донавчених кандидатів на базі Qwen3-8B у 12 версіях датасету так і не перевершили базову модель з промптингом.
Коли менша Qwen3-1.7B отримала більш різноманітні дані, а не просто більший обсяг, macro-F1 зріс із 0,584 (на 684 перевірених рішеннях) до 0,911 (на 2522 рядках, доповнених перефразуваннями). Контрольний прогін тих самих 684 рядків на 11 епохах дав лише 0,879 — більше проходів по тих самих даних не замінює різноманітність формулювань.
Межі підходу і що перевірити перед довірою до результату
Фронтир-модель відкинули одразу з трьох причин: завдання вузьке й прив'язане до власного обладнання компанії, об'єкти працюють без GPU і часто без інтернету, а оплата кожного запиту на тисячах майданчиків економічно не масштабується. Якщо завдання широке й неповторюване, донавчання компактної моделі такого виграшу не дасть.
Перед тим як довіряти автономним рішенням моделі, в Exowatt перевіряють дві речі: кожне твердження прив'язане до конкретного рядка вхідних даних (непідтверджені заяви система відкидає ще до оператора), і модель явно відмовляється відповідати, якщо доказів недостатньо, замість того щоб вгадувати. Ці перевірки дозволили випробувати модель автономно на хмарній копії об'єкта, перш ніж довірити їй реальні рішення.