Нові моделі Claude потребують ревізії старих промптів
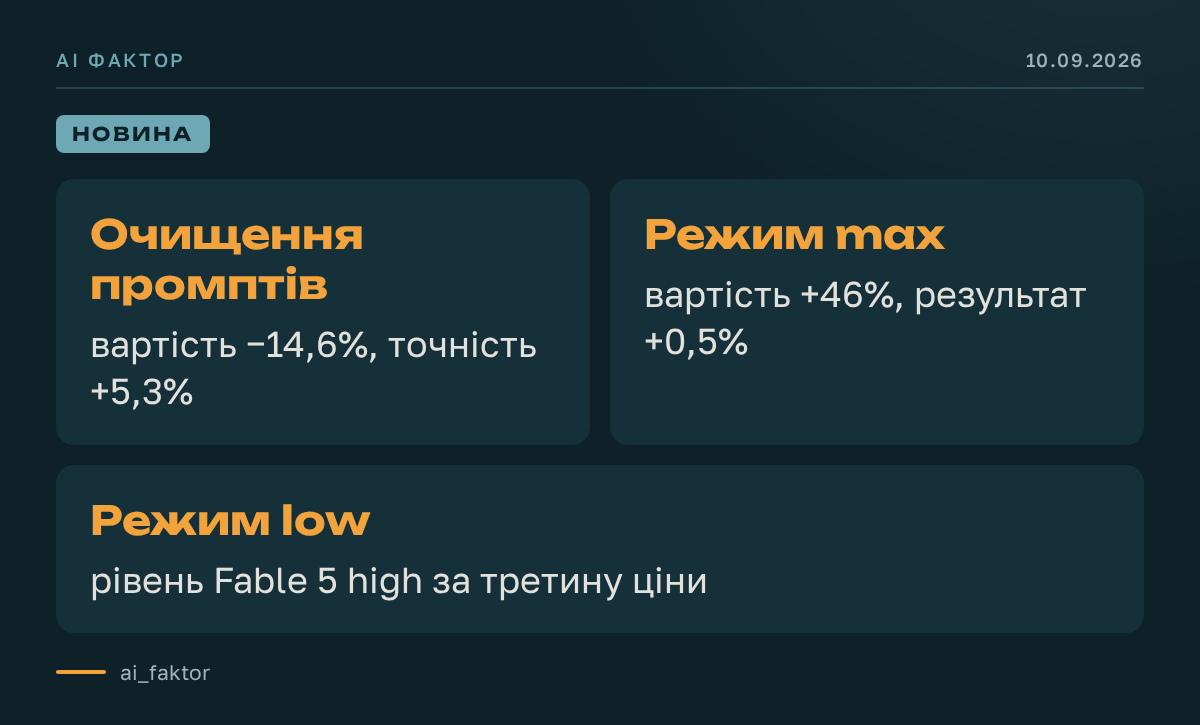
Anthropic показала, як старі інструкції збільшують витрати на нових моделях. У тесті підтримки їх очищення знизило середню вартість на 14,6% і підвищило точність на 5,3%. На HLE у Fable 5.1 режим max коштував на 46% більше, а результат зріс лише на 0,5%, у межах похибки. На CursorBench 3.2 Fable 5.1 із low зрівнялася з Fable 5 на high приблизно за третину ціни.
Витрати залежать і від кешу: час, ID або новий порядок описів інструментів у системному промпті скидають його, бо префікс має збігатися повністю. Для аудиту Anthropic додала в claude-api skill команди /claude-api prompt-audit і /claude-api cost-optimize.
Чому старі інструкції стають дорожчими
Проблема не лише в довжині промпту. Правила, які свого часу компенсували слабкі сторони попередніх моделей, можуть змушувати нову модель виконувати зайву роботу або некоректно взаємодіяти з інструментами.
У наведених прикладах вимога відповідати максимально докладно спричиняла десятки зайвих пошуків у базі знань. Інша інструкція — обов’язково писати чернетку міркувань — іноді призводила до того, що виклики інструментів з’являлися в міркуваннях, але фактично не виконувалися. Тому очищення промптів може одночасно скоротити витрати й підвищити якість: у тесті на завданнях підтримки середня вартість зменшилася на 14,6%, а точність зросла на 5,3%.
Максимальний рівень міркувань потрібен не завжди
Режим із найбільшим обсягом міркувань не гарантує пропорційного поліпшення результату. На HLE перехід Fable 5.1 на рівень max збільшив вартість на 46%, тоді як показник зріс лише на 0,5% — і це поліпшення залишалося в межах похибки тесту.
Порівняння на CursorBench 3.2 показало інший спосіб оптимізації: Fable 5.1 із рівнем low досягла результату Fable 5 із high, але приблизно за третину вартості. Практичний висновок для команд, які оплачують API: під час переходу на сильнішу модель варто заново перевірити налаштування effort, а не автоматично залишати максимальний режим.
Як системний промпт впливає на кеш
Кеш працює лише тоді, коли його префікс збігається повністю. Через це навіть технічно незначна динамічна частина на початку системного промпту здатна скинути весь наступний кеш і збільшити повторні витрати.
- час або часова мітка, що постійно змінюється;
- динамічний ID у системному промпті;
- зміна порядку описів інструментів;
- надто тривале виконання інструментів агентом, через яке спливає строк життя кешу.
Для команд, які використовують агентів із базами знань та іншими інструментами, це означає, що під час аналізу витрат потрібно перевіряти не тільки кількість токенів у запиті, а й стабільність кешованого префікса.
Що саме переглянути під час переходу
Anthropic вбудувала відповідні перевірки в claude-api skill для Claude Code. Команда /claude-api prompt-audit призначена для перевірки промптів, а /claude-api cost-optimize — для пошуку місць, де можна зменшити витрати на API.
Предметом ревізії мають бути старі файли CLAUDE.md, скіли та налаштування effort. Насамперед варто шукати правила, додані як обхідні рішення для попередніх моделей: вимоги до надмірної деталізації, примусові чернетки міркувань і максимальний рівень reasoning. Їх слід перевіряти повторними тестами на тих самих робочих завданнях, порівнюючи не лише результат, а й фактичну вартість виконання.