ШІ-агенти не вміють оцінювати час роботи
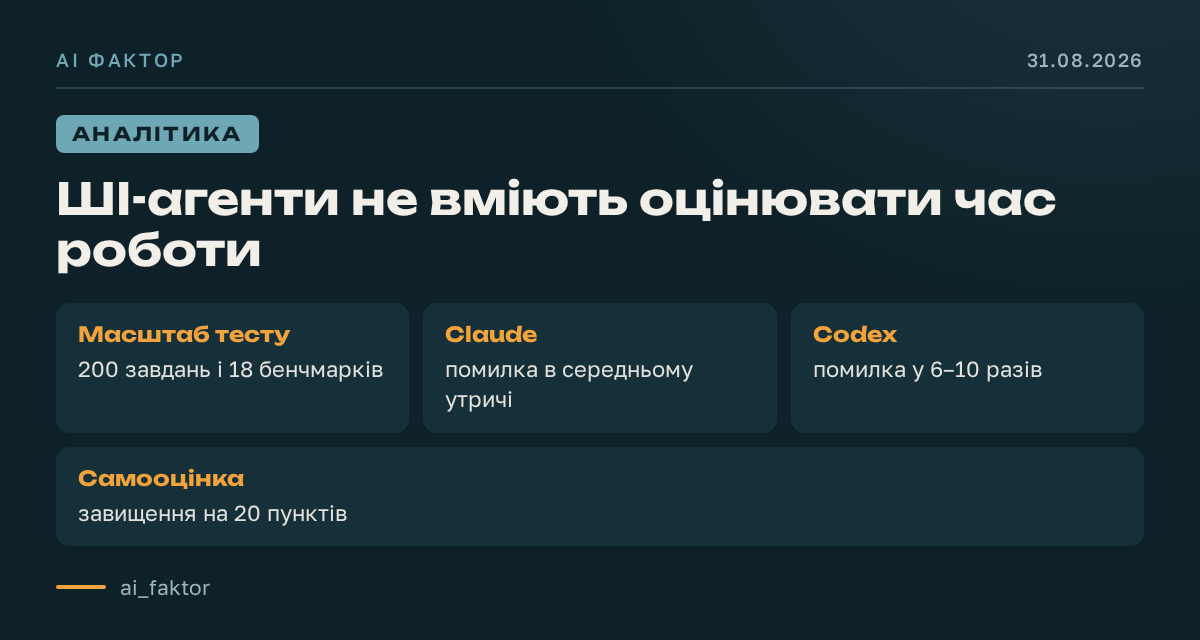
Дослідники MATS перевірили Claude Code й OpenAI Codex на 200 завданнях ProgramBench і 18 власних тестах. Обидва часто прогнозували близько 90 хвилин незалежно від складності. Claude помилявся в середньому утричі, Codex — у 6–10 разів. При цьому Claude Code працював медіанно близько 90 хвилин, а Codex зупинявся приблизно за пів години.
Час залежав і від програмного середовища: та сама модель у Claude Code робила у 2,5 раза більше кроків, ніж у Codex. Самооцінка також підводила: Opus 4.8 і GPT-5.5 завищували результат у середньому на 20 пунктів. В одному тесті вони оцінили успіх у 70%, хоча фактичні бали становили 7% і 14,5%.
Як саме перевіряли відчуття часу
Двоє незалежних дослідників у межах програми MATS тестували не лише здатність Claude Code та OpenAI Codex виконувати завдання, а й дві окремі оцінки часу. Перед початком агент мав спрогнозувати тривалість роботи, а після завершення — повідомити, скільки часу, на його думку, вже минуло.
Матеріал складався з 200 завдань добірки ProgramBench і власного набору з 18 тестів. На ProgramBench обидва агенти переважно називали близько 90 хвилин незалежно від складності. В іншій серії середня похибка Claude була трикратною, а Codex — від шести до десяти разів. Найгіршими прогнози були для коротких завдань; лише на роботах тривалістю кілька годин деякі оцінки наближалися до фактичного часу.
Чому модель — лише частина результату
Тривалість визначалася не тільки мовною моделлю, а й програмним оточенням, або harness. Claude Code продовжував роботу, доки вважав завдання завершеним: медіанний час становив близько 90 хвилин. Codex зупинявся приблизно через пів години майже незалежно від завдання.
За даними дослідження, одна й та сама мовна модель у Claude Code в середньому робила у 2,5 раза більше кроків, ніж у Codex. Отже, оцінювати тривалість агентної роботи лише за назвою моделі недостатньо: поведінка суттєво залежить від системи, у якій вона запущена.
Самооцінка якості теж ненадійна
Окремо дослідники перевірили, чи здатні агенти оцінювати власний результат. Старші моделі Opus 4.8 і GPT-5.5 у середньому завищували оцінку на 20 пунктів і ставили собі високі бали навіть за невдалі роботи. В одному тесті обидві моделі вважали завдання виконаним приблизно на 70%, тоді як фактичні результати становили 7% і 14,5%.
Для керівників команд, які розглядають агентів для багатогодинних завдань, практичне обмеження полягає в керованості: агент, що помиляється щодо минулого й потрібного часу, не може надійно виконувати інструкції на кшталт працюй над завданням дві години. Так само його власна висока оцінка не підтверджує якість виконання.
Що вже спрацювало і чого ще не перевірили
Коли агентам дали інструмент, який показує фактично минулий час, вони визначали його правильно майже завжди. Це вказує, що проблема принаймні частково залежить від доступу до зовнішнього вимірювання, а не лише від здатності моделі міркувати про час.
Водночас дослідження ще не відповідає, чи зможуть агенти стабільно дотримуватися наперед заданої тривалості роботи: автори називають це наступним етапом тестування. У джерелі також немає умов доступу, дат запуску чи ціни будь-якого рішення — йдеться про результати експерименту, а не про готову функцію для користувачів.