WikiSkill вчить ШІ-агентів на минулих помилках
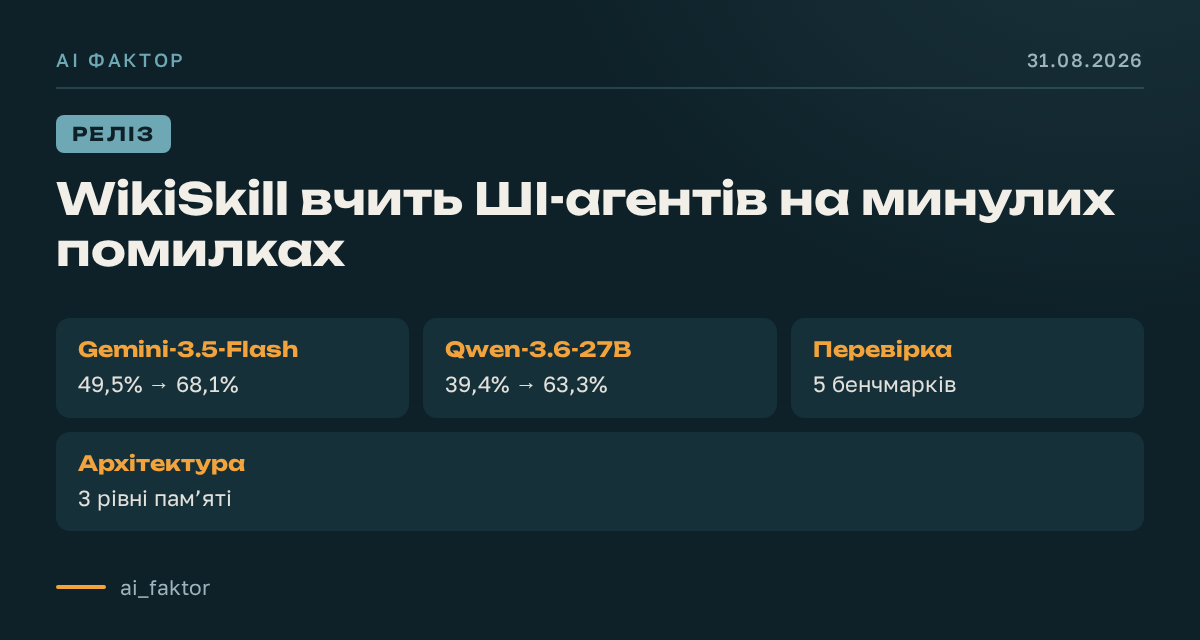
Google Research представила WikiSkill — постійну базу знань для ШІ-агентів. Система зберігає журнали виконання, виділяє успішні стратегії й типові збої та створює з них інструкції Agent Skills. Зміни тестують окремо й відкочують, якщо результат гіршає.
На п’яти тестах із математики, вебпошуку, таблиць, документів та інтерактивних завдань результат Gemini-3.5-Flash зріс із 49,5% до 68,1%, а Qwen-3.6-27B — із 39,4% до 63,3%. Найбільший приріст дали математика й таблиці, менший — довгі документи. Підхід покращує агентів без перенавчання моделі.
Як система перетворює досвід на інструкції
WikiSkill розділяє робочий простір агента на три рівні. Raw Layer зберігає повні й незмінні журнали виконання: виклики інструментів, отримані результати та інші сліди роботи. Wiki Layer перетворює ці дані на структуровані описи успішних стратегій і типових помилок. За словами дослідників, цей рівень не скидається, а накопичує знання з кожною ітерацією.
На верхньому Skill Layer містяться активні процедурні інструкції, за якими агент виконує завдання. Спочатку агент працює з поточними навичками. Потім компонент Wiki Maintainer аналізує журнал, а Skill Proposer пропонує точкові зміни до інструкцій.
- Нову версію навички перевіряють на окремому валідаційному наборі.
- Якщо результат погіршується, оновлення навички відкочують.
- Запис про невдалу спробу залишається у вікі разом із поясненням, що саме не спрацювало.
Це не безперервне навчання моделі
WikiSkill не змінює знання, отримані моделлю під час тренування. Агент фактично створює кращі інструкції для самого себе та дістає їх під час наступних запусків. Безперервне навчання моделі залишається нерозв’язаним завданням, а WikiSkill пропонує обхідний механізм через зовнішню накопичувальну пам’ять.
Підхід розвиває ідею Андрея Карпатого про LLM Wiki — збирання досвіду в постійну й кумулятивну базу знань. Водночас активні навички та накопичені записи розділено: інструкцію можна відкотити, не видаляючи історію, на якій вона ґрунтувалася.
Де приріст був найбільшим
Дослідники перевірили WikiSkill на п’яти типах завдань: математичні міркування, вебпошук, робота з електронними таблицями, відповіді на запитання за документами та інтерактивні дії у віртуальному середовищі. У тестах брали участь моделі Qwen на 4B, 9B і 27B параметрів, Gemma-4-31B та Gemini-3.5-Flash. У таблиці дослідження наведено середні результати трьох незалежних запусків.
- На LiveMath результат Gemini-3.5-Flash зріс із 33,0% до 72,6%.
- На SpreadSheet — із 50,5% до 76,6%.
- У більшості комбінацій моделей і тестів WikiSkill показав найкращий або статистично еквівалентний найкращому результат.
Ефект залежав від типу роботи. Найбільші покращення зафіксовано в математиці та операціях із таблицями. У завданнях OfficeQA з довгим контекстом документів приріст був значно меншим.
Для яких агентів це працює краще і що ще не визначено
Більші моделі загалом краще використовували навички, що еволюціонували. Менші моделі, зокрема Qwen-3.5-4B, мали труднощі з надійним виконанням багатокрокових пошукових стратегій у довгому контексті й поверталися до типової поведінки. Водночас менша модель із WikiSkill могла зрівнятися з більшою моделлю без цього механізму.
Навички, створені однією моделлю, часто переносилися на іншу, а іноді працювали краще за інструкції, які модель-одержувач створила самостійно. Проте це відбувалося не завжди, тому сумісність потрібно перевіряти окремо для кожного випадку.
У матеріалі немає дати публічного запуску, умов доступу, ціни чи опису готового продукту для компаній. Також не наведено виробничих випробувань у фінансах, бухгалтерії, праві або HR. Тому практичне значення поки обмежене результатами дослідження на зазначених тестах, а застосувати WikiSkill як готовий корпоративний сервіс за наведеними даними наразі не можна.