Grok 4.7 вдвічі дешевший за GPT-5.6 Sol
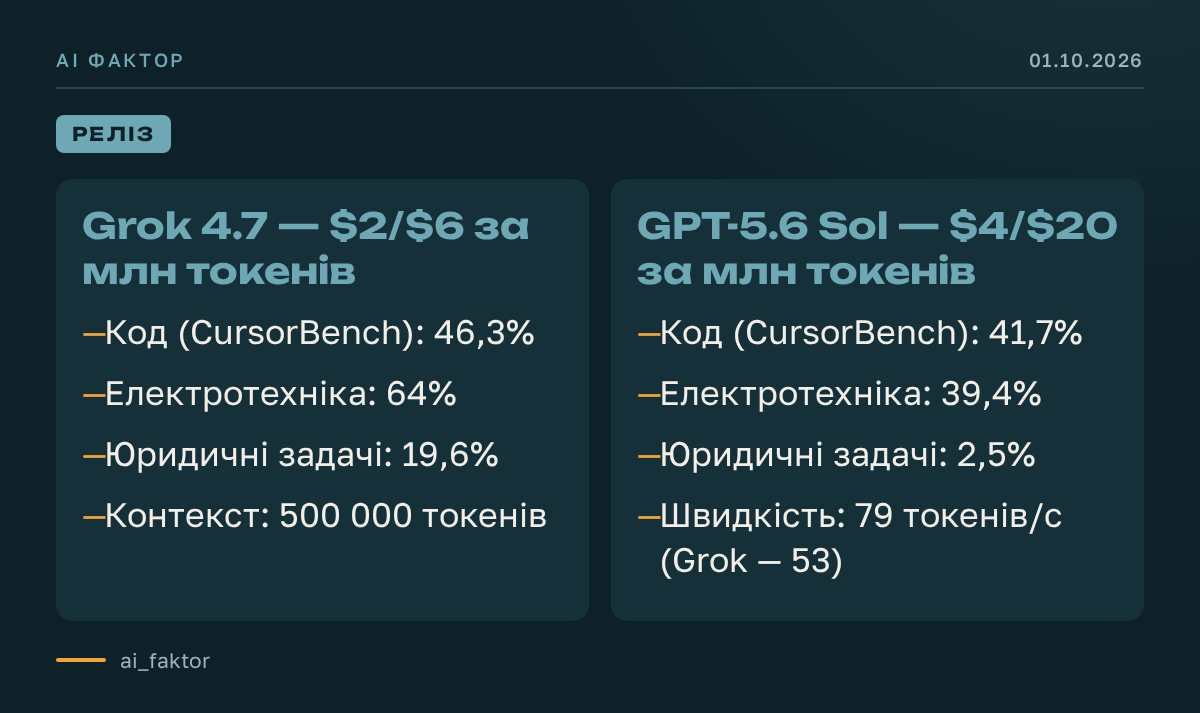
21 вересня 2026 xAI випустила Grok 4.7 за тією ж ціною, що й попередня версія: $2 за мільйон вхідних токенів і $6 за мільйон вихідних. GPT-5.6 Sol Max коштує $4 і $20 — у 2-3 рази дорожче. За даними xAI, Grok 4.7 обходить конкурента в коді (CursorBench 4.0: 46,3% проти 41,7%) і електротехніці (64% проти 39,4%), а в юридичних задачах розрив ще більший — 19,6% проти 2,5%. Виняток — DeepSWE v1.1, де GPT-5.6 Sol сильніший (72,7% проти 71%) і швидший у генерації (79 проти 53 токенів/с). Модель вже доступна в Cursor і Grok Build, контекстне вікно — 500 000 токенів.
Контекст: що було до Grok 4.7
Grok 4.7 — не дебютна модель, а продовження лінійки xAI. Попередня версія, Grok 4.6, вийшла 12 серпня 2026 року і, за оцінками xAI, вже наблизилася до GPT-5.6 Sol за «індексом інтелекту». Grok 4.7 зберігає ту саму ціну, але побудований на новій масштабній базовій моделі.
За описом xAI, модель тренували довшим і інтенсивнішим навчанням з підкріпленням (RL), на мікс завдань, що свідомо акцентує складні задачі, які вимагають годин роботи, — тобто орієнтувались не на прості запити, а на завдання, подібні до тих, що вирішують фахівці. Окремо модель навчили «нативно розуміти» механіку власного чат-асистента Grok Bot, що, за словами xAI, покращило якість розмовних задач і роботи зі знаннями. Дата відсікання знань моделі — травень 2026 року.
Професійні задачі: де це відчують юристи та фінансисти
Крім бенчмарків з коду, електротехніки та права, xAI наводить результати тесту AA Briefcase v1.1, який відтворює реальні робочі задачі юристів, медсестер і фінансових аналітиків — тобто напряму стосується не програмування, а типової офісної роботи:
- Grok 4.7 — 1657 балів
- Grok 4.6 — 1546 балів
- GPT-5.6 Sol — 1487 балів
У коді найвищий результат Grok 4.7 на CursorBench 4.0 отримано в режимі xHigh — цей бенчмарк спеціально розрахований на довгі, багатоетапні задачі програмування, а не на автодоповнення коду.
Безпека: окремий напрямок розробки
xAI заявляє, що для Grok 4.7 побудований «цілком новий стек захисту», і описує модель як таку, що найкраще серед усіх протестованих нею моделей відмовляється виконувати небезпечні запити й стійкіша до джейлбрейків:
- HackerBench v0.3 (шкідливі кіберзадачі): лише 3,3% ризикованих запитів пройшли через захист моделі
- LatchBio biosafety benchmark (біобезпека): 62,4% — найвищий результат серед порівнюваних моделей
Окремим кібербезпековим партнерам xAI надала доступ за запрошеннями до функцій «red teaming» моделі — для досліджень оборонного спрямування.
Доступ до моделі
Grok 4.7 доступна для безкоштовного випробування через Cursor, Grok Build і API xAI. Умов і термінів дії безкоштовного доступу, а також дати, з якої діють наведені ціни на постійній основі, у матеріалі не уточнено.