Grok 4.7: та сама ціна, вищі рахунки
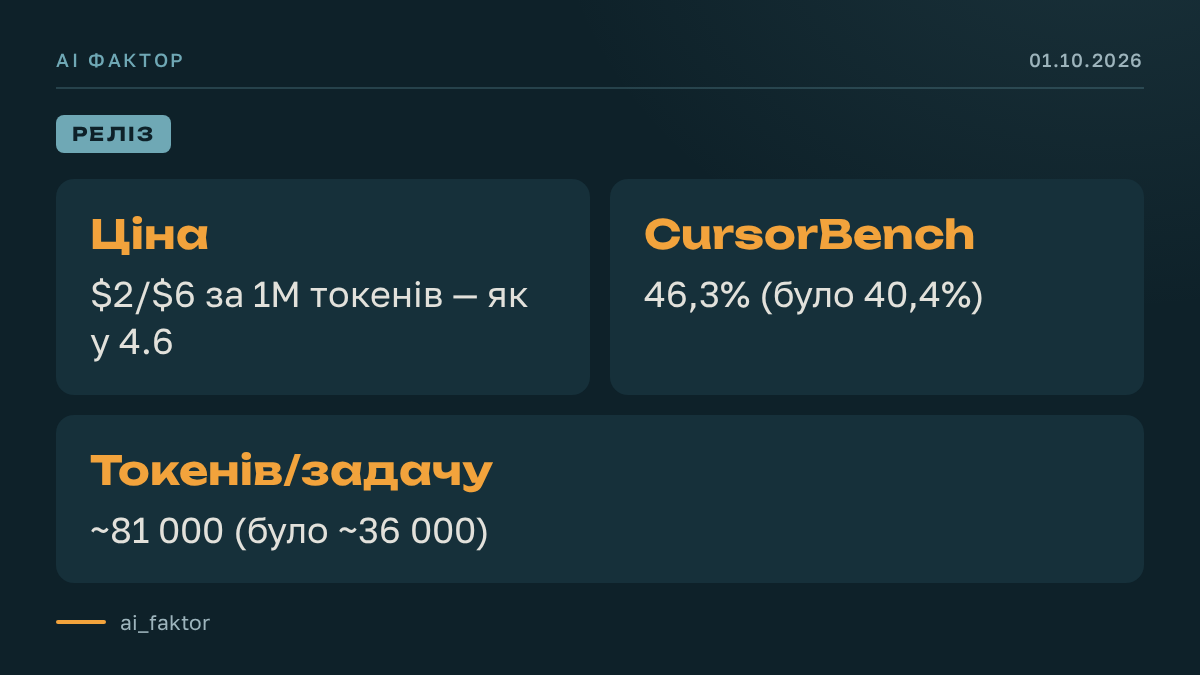
21 вересня xAI випустив Grok 4.7 — спершу в Cursor, Grok Build і API, у вебчаті й мобільному додатку з'явиться пізніше. Тариф як у 4.6: $2/$6 за 1 млн вхідних/вихідних токенів. "Вдвічі дешевше" з анонсу — це порівняння з GPT-5.6 Sol ($4/$20) і Fable 5.1 ($10/$50), а не знижка від 4.6.
На бенчмарках приріст помірний: CursorBench 46,3% проти 40,4% у 4.6 (у Fable 5.1 — 51,8%). А токенів на задачу йде ~81 000 замість ~36 000 у 4.6 — тому підсумковий рахунок за довгі задачі може зрости навіть при тій самій ціні за токен.
Де вже доступна модель і де ще ні
Окрім Cursor, Grok Build і API, xAI одразу відкрила доступ до Grok 4.7 через надбудови Grok для Word, PowerPoint та Excel, а також через сторонні шлюзи — OpenRouter, Vercel, Cloudflare. У Cursor модель працює на десктопі, у вебі, в CLI та через SDK.
З платними тарифами Cursor є розбіжність між офіційними джерелами: довідка Cursor називає конкретні плани — Start (для Індії), Pro, Pro+, Ultra, Teams, Enterprise, — тоді як картка моделі просто вказує «всі тарифні рівні». Самі офіційні джерела в цьому не узгоджені між собою.
Контекстне вікно, за даними Artificial Analysis, становить 500 000 токенів; довідка Cursor вказує стандартний контекст у 256 000 токенів, а все, що понад нього, тарифікується за правилами для довгого контексту. Кешований вхід коштує $0,50 за мільйон токенів.
Що змінилося під капотом
За описом xAI, Grok 4.7 — більша базова модель, ніж 4.6, яку довше навчали з підкріпленням на складніших задачах, що вимагають годин безперервної роботи; це мало покращити здатність моделі перевіряти власний результат. Картка моделі також зазначає, що для донавчання використали знеособлені дані робочих сесій Cursor.
Відсікання даних для попереднього навчання — червень 2026 року, додаткове навчання тривало до серпня. Окремо картка моделі прямо застерігає: важливі медичні, юридичні чи фінансові рішення не варто довіряти моделі без перевірки людиною та експертом.
Бенчмарки: помірний прогрес, не стрибок
На тестах термінальних задач (Terminal-Bench 4.0) офіційна таблиця xAI показує 37,6% для Grok 4.7, картка моделі — 38,0% (версія Grok Build/xhigh); для порівняння, 4.6 — 20,3%, GPT-5.6 Sol — 37,3%, Fable 5.1 — 57,9%.
У юридичному тесті Harvey Legal Agent Benchmark модель показала 19,6%, у клінічному мисленні (HealthBench Professional) — 56,7%; це вище за 4.6, але нижче за Sol і Fable.
За незалежною оцінкою Artificial Analysis, загальний Intelligence Index моделі — 46 пунктів (+2 відносно 4.6), а Elo у GDPval-AA — 1695 проти 1605 у Grok 4.6 (high). Це виглядає радше як поступове покращення, ніж зміна покоління.
Що це означає для тих, хто рахує токени
У тій самій незалежній оцінці Grok 4.7 (xhigh) витрачає на задачу близько 81 000 вихідних токенів проти приблизно 36 000 у Grok 4.6 (high) і близько 27 000 у GPT-6 Astra (max). Тобто за однакову ціну за токен підсумковий рахунок за довгі задачі з міркуванням усе одно може вийти вищим — заголовкове «удвічі дешевше» і реальний рахунок за API варто рахувати окремо.
Для компаній, що вже платять за Cursor або Grok API, перехід на 4.7 не потребує додаткових дій і не змінює тарифну сітку — зміниться лише фактичне споживання токенів на задачу. Точної дати запуску Grok для вебу, мобільного застосунку та X матеріал не наводить.