Роутер перед Gemini: thinking level важливіший за ліміт токенів
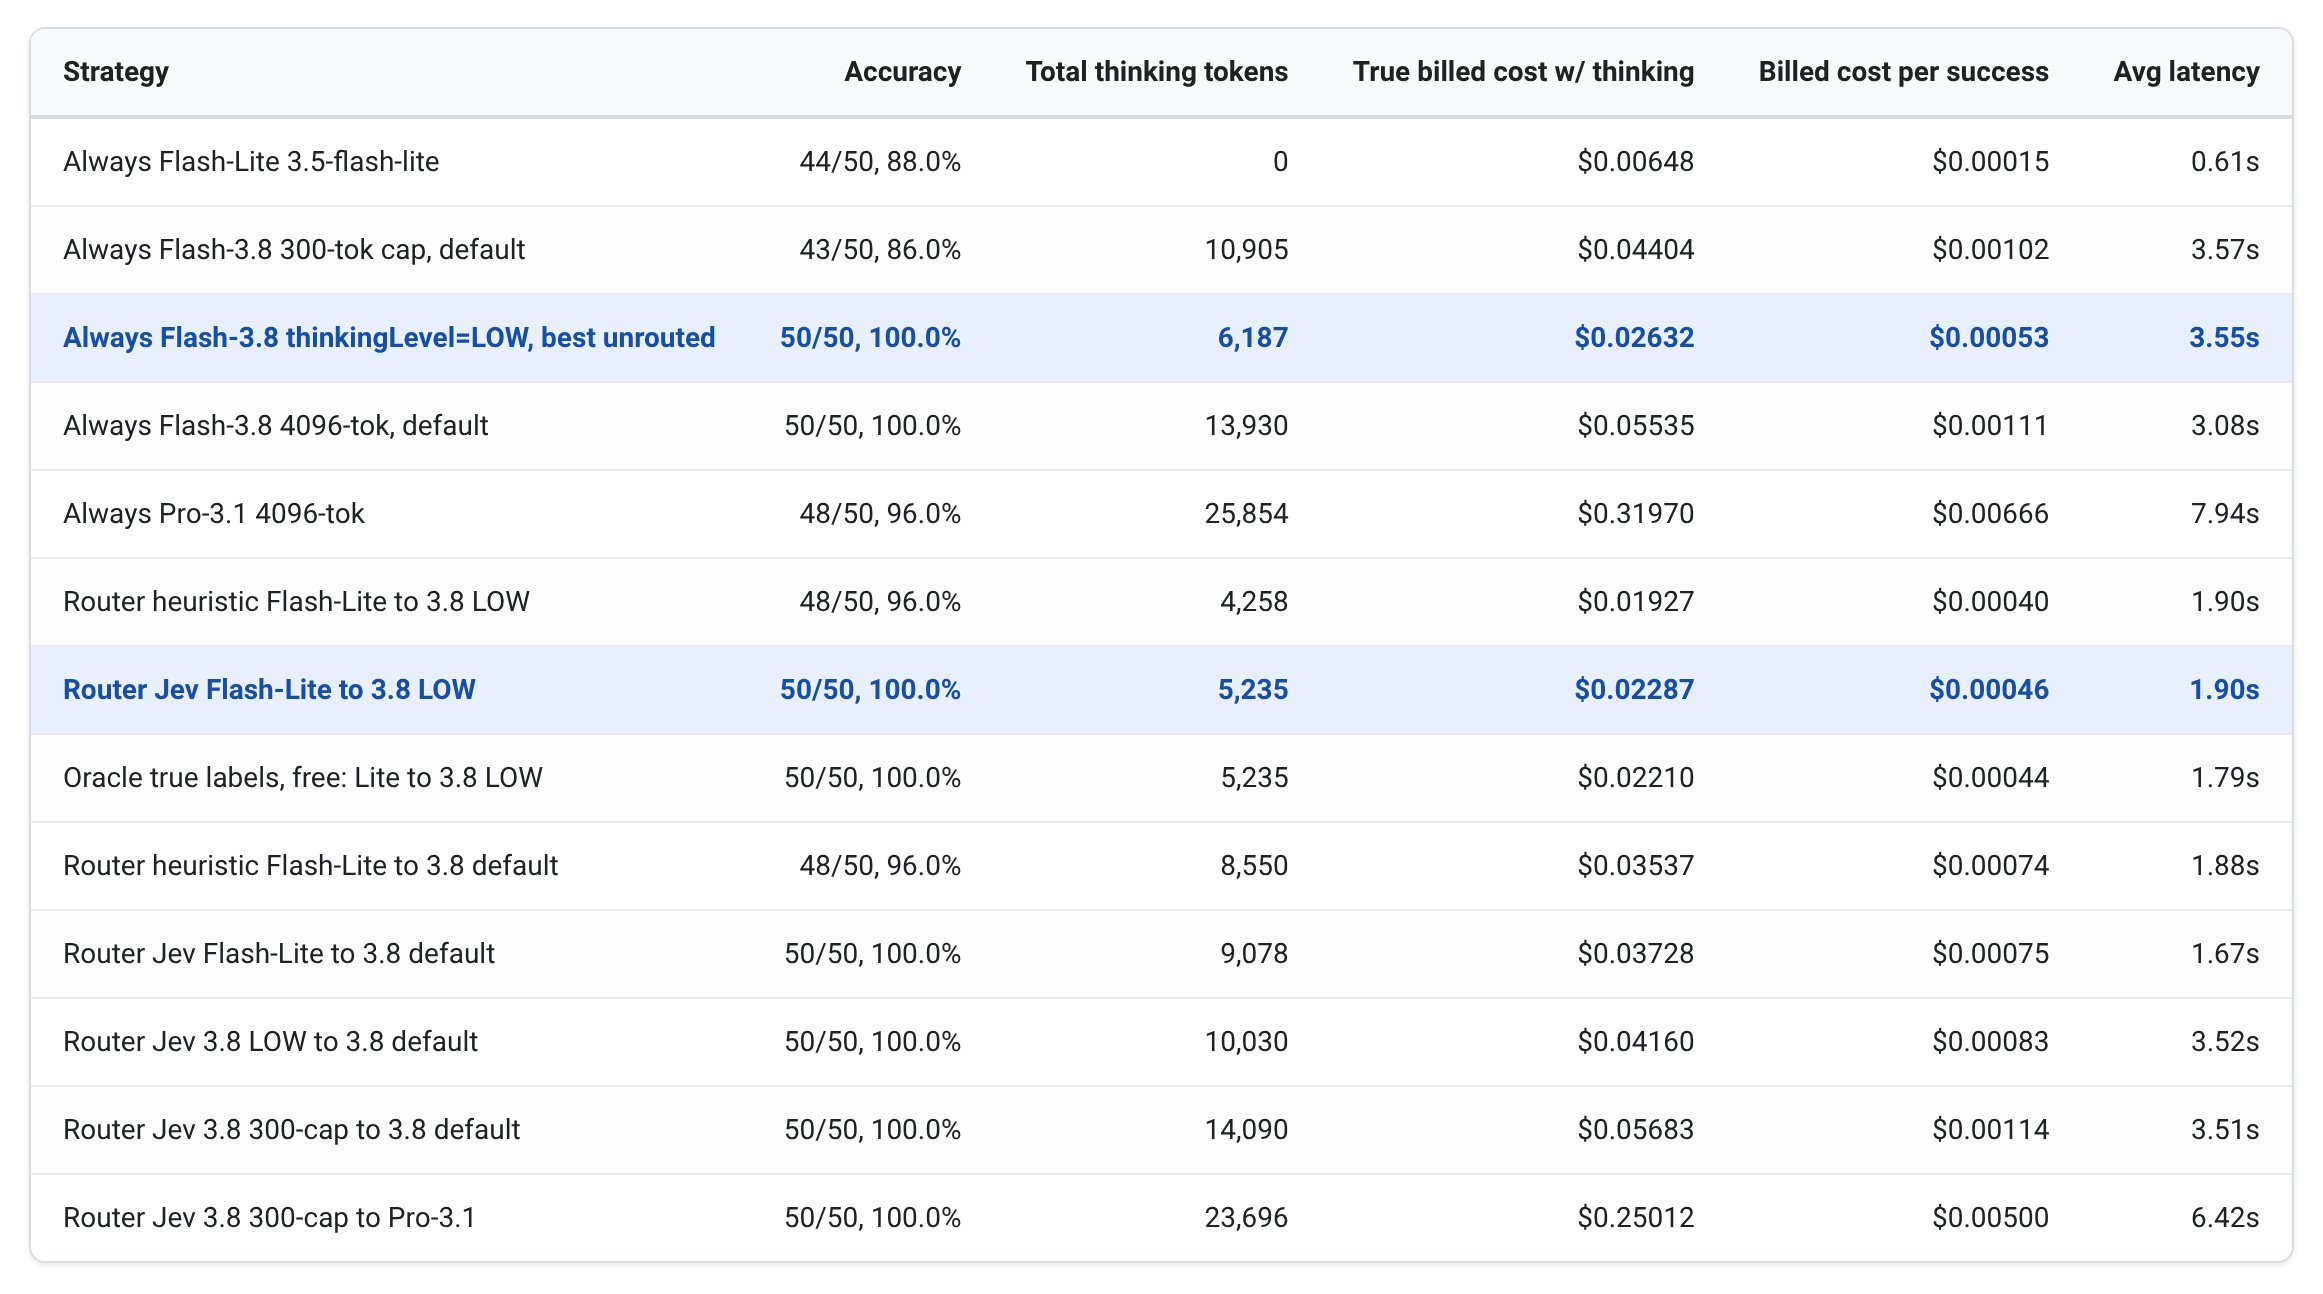
Google прогнав 50 задач кодинг-агента через Gemini, поставивши перед моделлю класифікатор Jev від TypeSafe. Партнерства з TypeSafe немає, Jev тут лише приклад. Одне атомарне `noul`-питання «чи треба більше одного послідовного кроку» розмітило 48 із 50 задач так само, як вручну. Regex-евристика на нових задачах впала до 70,6%. Flash-Lite з ескалацією на Gemini 3.8 Flash low розв’язав усі 50. Low на всьому теж розв’язав усі 50, але роутер швидший, а ціна на коротких промптах майже однакова.
Чому ліміт виходу не зменшує роздуми
Автори порівнюють конфігурації за вартістю успішної задачі: усі ітерації, виклики інструментів, повтори й thinking-проходи, поділені на кількість задач, що пройшли перевірку. Ціна за мільйон токенів тут вторинна.
Для перевірки взяли gemini-3.8-flash з maxOutputTokens=300 і з maxOutputTokens=4096, а thinkingConfig лишили за замовчуванням. На 27 простих задачах обидві конфігурації витратили майже однаково thinking-токенів. Легкі відповіді до стелі не доходили, тому версія з лімітом вийшла навіть трохи дорожчою. Зате ліміт зламав 7 із 25 складних задач: у шести модель вичерпала місце ще під час міркувань і не відповіла, у сьомій стиснула міркування й помилилась. Роутер «прості — на модель з лімітом, складні — на звичайний Flash» розв’язав усі 50, але був трохи дорожчим і повільнішим за звичайний Flash на всьому. Тому рівень мислення задавайте напряму: thinkingLevel: "LOW".
Як питати класифікатор
Перша спроба була одним широким Choice-питанням «simple чи complex». На 16 задачах вона відправила майже все в simple, зокрема трасування LRU-кешу й модульне піднесення до степеня. Документація TypeSafe застерігає саме від цього: питання, яке зважує кілька факторів або вимагає метаоцінки, треба розкласти на атомарні перевірки. Одне noul-питання (ймовірність від 0 до 1 для бінарного твердження) одразу розділило задачі:
Answering this requires performing more than one sequential calculation, simulation step, or logical deduction, rather than a single direct lookup, format check, or one-step classification.
На стартових 16 задачах збіг із ручною розміткою становив 13 у першому прогоні і 14 у другому. Якщо факторів кілька, на кожен ставте окреме питання «так/ні».
Де ламається regex-евристика
Евристика шукала слова на кшталт sequence, modulo, race condition і ескалювала кожен промпт, довший за 35 слів. На 16 задачах, під які її писали, вона дала 93,8%. Потім її код заморозили й прогнали на 34 нових задачах із семи категорій, і результат упав до 70,6%:
- хибна ескалація: порт із Kubernetes YAML, шлях файлу із заголовка unified git diff, номер рядка з Python traceback — прості задачі, довші за 35 слів;
- хибно «прості»: мутабельні аргументи за замовчуванням між викликами, хешування ключів у
{1: "a", True: "b", 1.0: "c"}, short-circuit у C — короткі й без «підозрілих» слів.
Роутер на евристиці вийшов дешевшим лише через помилки: 5 складних задач пішли на Flash-Lite, 2 з них провалились. Flash-Lite сам по собі пропустив 6 із 25 складних задач, і Jev з високою впевненістю позначив усі шість як складні.
Межі прийому і що перевірити
- Кешування. Context Caching знижує ціну повторної передачі контексту на 75–90%, але кеш належить одній моделі. Короткі самодостатні задачі (парсинг логів, перевірка схем) маршрутизуйте, а довгі контекстні ходи тримайте на одній моделі.
- Важча ескалація. Flash з thinking за замовчуванням для складних задач коштував більше, ніж low на всьому. Вона має сенс, лише коли low почне помилятися.
- Pro і безпека. Конфігурація Gemini 3.1 Pro відхилила два короткі промпти на security review коду, на які Flash відповів. Ці промпти тестуйте на тій конфігурації, яку плануєте використовувати.
- Свій класифікатор. Codelab Getting started with discriminative models запускає Choice, Score і Noul на DiffusionGemma у вашому Google Cloud, і в роутері змінюється лише endpoint. Точність і затримку міряйте самі. Самохостинг оплачується за GPU-годину, а не за токени.
- Витрати. Трейси й кількість thinking-токенів відправляйте в Cloud Logging і BigQuery, щоб ловити обрізання й повтори.
Межі тесту: по одному прогону на конфігурацію, 50 промптів із ручною оцінкою складності, проста автоматична перевірка. Порівняння швидкості з Flash за замовчуванням і з Pro автори радять вважати приблизним.