Agents CLI: зламаний промпт ловить eval, а не тести
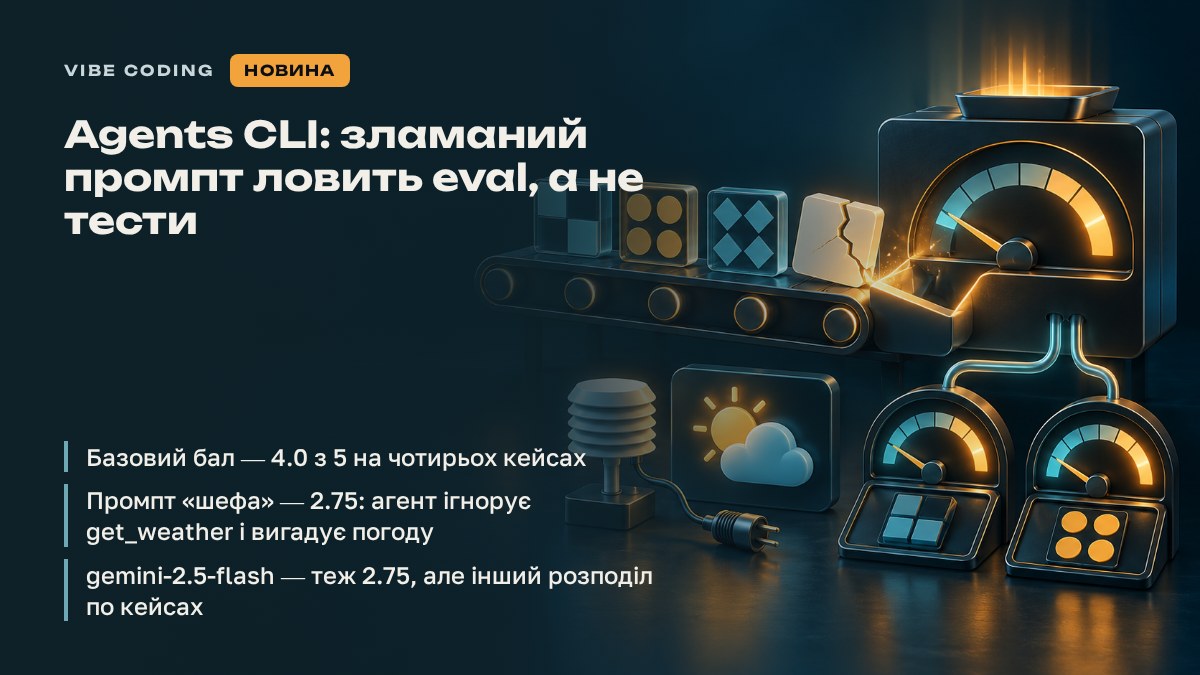
Google показав цикл оцінки агентів в Agents CLI. `eval generate` проганяє агента по датасету, `eval grade` оцінює трейси, `eval compare` порівнює два прогони, `eval analyze` групує збої за темами, а `eval optimize` автоматично підганяє промпт. На LangChain-шаблоні v1.8.0 із чотирма кейсами базовий бал склав 4.0 з 5, суддею був `gemini-3.8-flash`. Потім у агента помилково вставили промпт «шефа». Бал упав до 2.75: агент перестав викликати `get_weather` і почав вигадувати погоду.
Дивіться на кейси, а не на середній бал
Середнє 2.75 каже лише, що стало гірше. Де саме, показує agents-cli eval compare: передайте йому два файли результатів, базовий і новий, з artifacts/grade_results/. Він видає JSON-дифф, а в об'єкті differences лежать оцінки по кожному кейсу пліч-о-пліч. Автори радять витягати з нього сигнал через jq або короткий Python-скрипт.
У прикладі з промптом «шефа» просіли три кейси з чотирьох, і кожен по-своєму. greeting впав з 5 до 4, бо агент після «hello» почав пропонувати рецепт. off_topic впав з 5 до 3: агент відповів про World Series, але додав рецепт. rome_weather лишився на 2.0, бо агент вигадував погоду ще на базовому прогоні. Тому зберігайте повні JSON-файли результатів, а не лише бали. Без них такого розбору через три тижні не зробиш.
Друга ситуація: дешевша модель
У app/agent.py модель задано рядком LLM = "gemini-3.8-flash". Автори повернули нормальний системний промпт, поставили gemini-2.5-flash і знову прогнали generate та grade. Середнє впало так само, з 4.00 до 2.75, але картина інша. greeting і rome_weather не змінились, sf_weather втратив бал, а майже весь спад дав off_topic (5 → 1): модель відмовилась відповідати, бо подія для неї «ще не відбулась». Це артефакт дати зрізу навчання.
Висновок залежить від вашого трафіку. Якщо запитів на кшталт off_topic мало, заміну варто розглянути. Якщо таких запитів багато, модель не підходить. Тут є два застереження. Промпт, налаштований під сильнішу модель, на слабшій працює гірше, тому чесно порівнювати кожну модель з її власним налаштованим промптом. Суддю на час порівняння не міняйте: зміна судді — це окремий експеримент.
Нічний прогін і алерт
Планувальника в Agents CLI немає. Автори пропонують викликати скрипт із eval generate та eval grade --output $OUT/ через cron або Cloud Scheduler. Для нічного прогону беруть стабільний датасет regression.json, зазвичай на десятки чи сотні кейсів. Такий прогін ловить дрейф від тихих оновлень моделі в постачальника і від змін у даних інструментів.
Сповіщення робить окремий скрипт-обгортка. Він читає summary_metrics[0].mean_score із нового файлу та з базового (попередній прогін або закомічений еталон) і завершується з sys.exit(1), якщо падіння перевищує --threshold. На парі 4.0 → 2.75 з --threshold 0.1 він виводить FAIL і код 1. Цей ненульовий код і підхоплює cron, Cloud Scheduler або крок GitHub Actions, щоб надіслати алерт.
Де прийом ламається
eval optimizeлише для ADK. Він працює на фреймворку GEPA, а LangChain-розширення наразі не підтримує. Команда змінює тільки промпт: інструменти, структура агента й модель лишаються як були.- Перенавчання на метрику. GEPA іноді знаходить варіанти промпту, які отримують вищий бал лише тому, що підлаштовуються під формулювання метрики. Кандидатів перед тим, як переносити в агента, переглядає людина.
- Завеликий датасет для щоденної роботи. Набір, який іде годину, на кожну зміну ніхто не запускає. У внутрішньому циклі досить кількох кейсів, які проходять менше ніж за хвилину.
- Датасет і очікування в одному файлі. Тримайте входи (датасет) і критерії (
eval_config.yaml) окремо, обидва під контролем версій. Тоді видно, яка половина змінилась, коли рухається бал. - Прогони без дій. За власним дослідженням Google, кодинг-агенти з agents-cli запускають eval учетверо частіше, але після eval змінюють агента приблизно так само часто, як і без нього. Якість дає те, що ви робите з результатами прогону.