Google: чому вайб-чек не ловить збої агентів
Google описав типову помилку: оцінювати агента трьома-чотирма промптами в терміналі й оком перевіряти відповідь. Агент може зациклитись чи спалити токени — і все одно виглядати нормально. Приклад зі статті: зміна промпту може здаватися кращою при ручній перевірці, а тести показують подвоєння затримки і зростання галюцинацій тулів на 15%.
Google пропонує відкритий agent-eval toolkit: фіксує трейси й передає в Agent Evaluation на Gemini. Підхід: critical user journeys і булеві LLM-judge перевірки замість оцінок 1-5. До продакшн-якості агента зазвичай потрібно 50-60 малих ітерацій.
Три ситуації, де «виглядає нормально» ламається
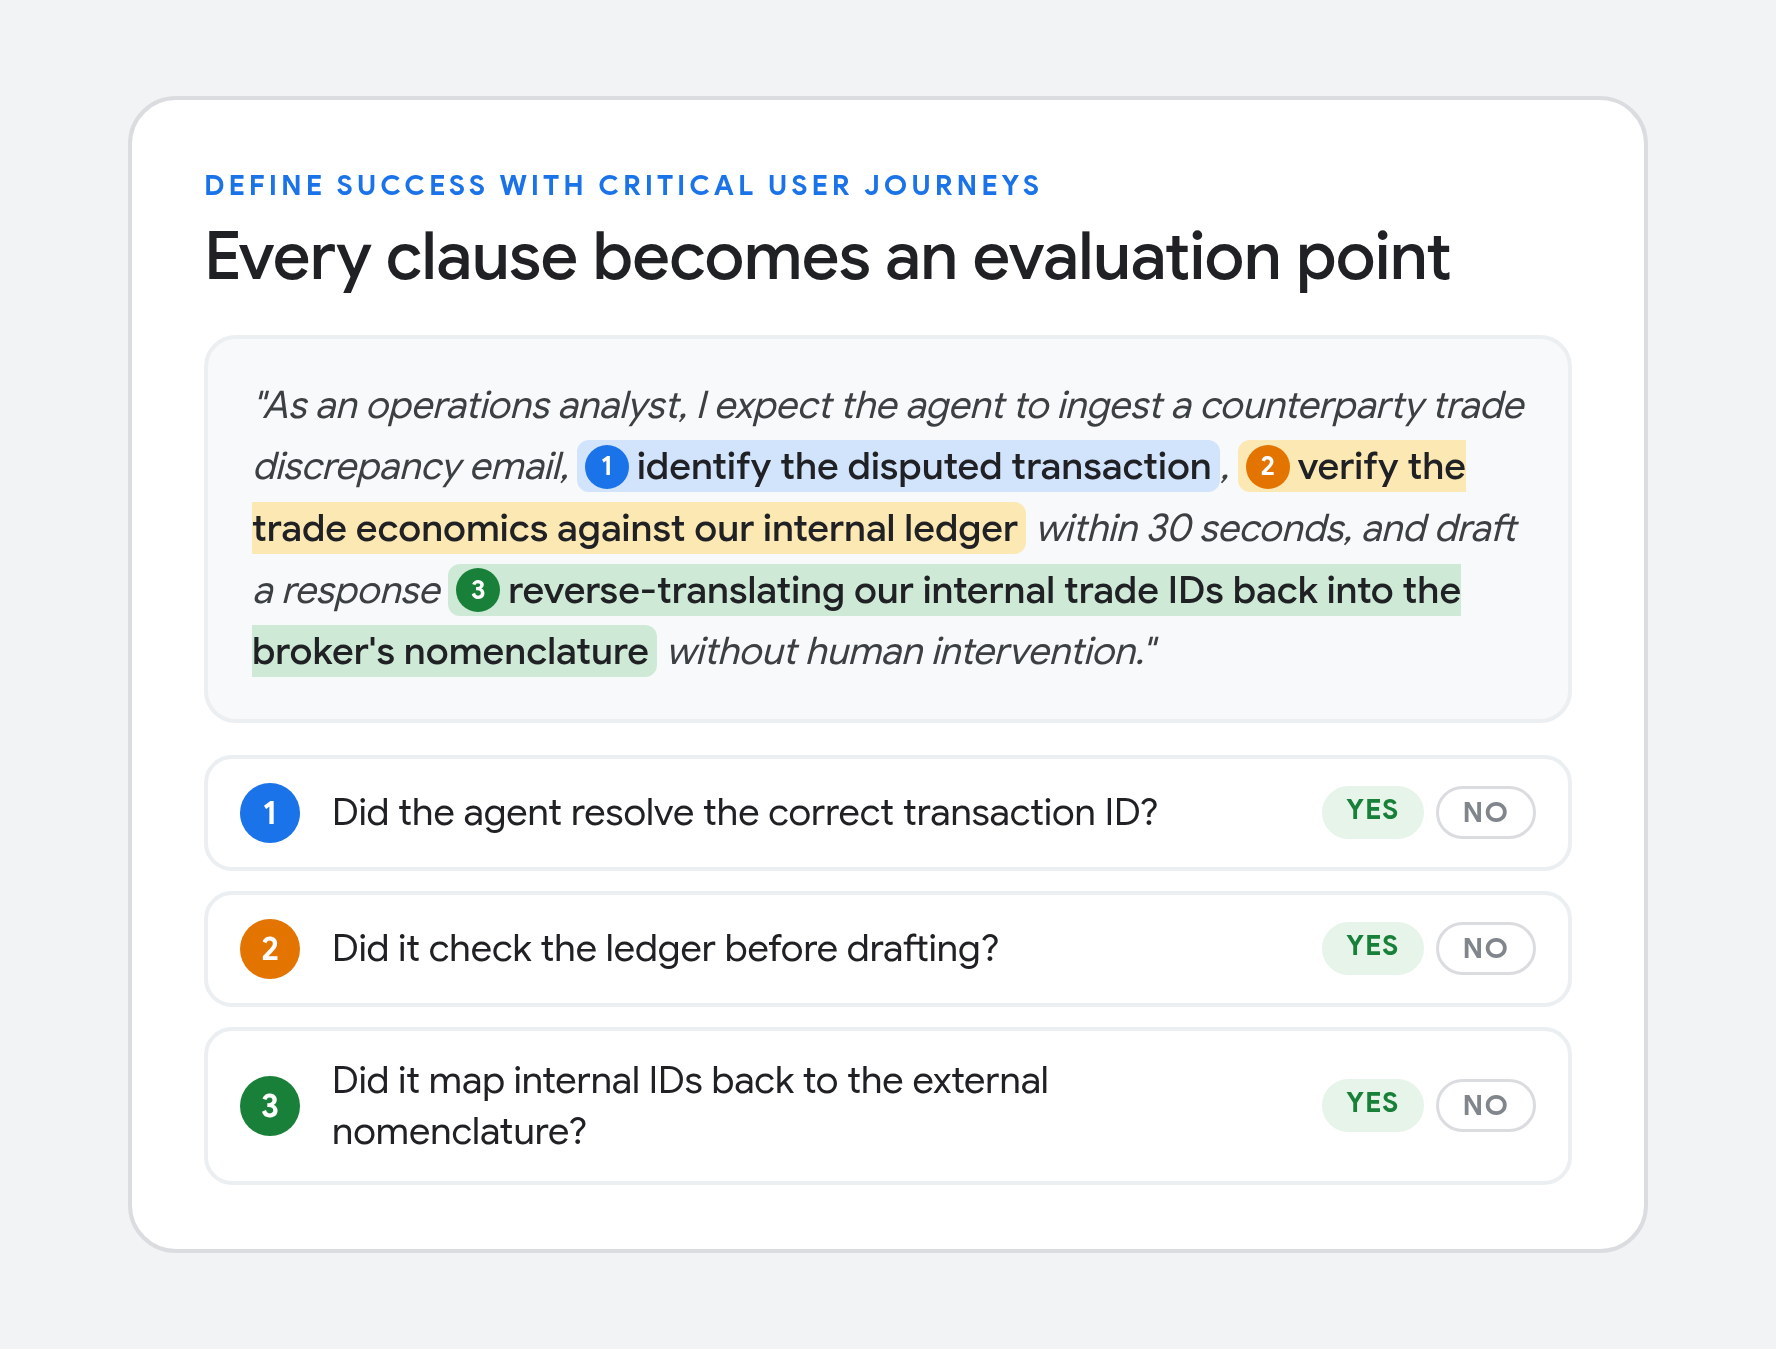
Джерело дає приклад critical user journey (CUJ) для агента, що розбирає спірні транзакції: «Як операційний аналітик, я очікую, що агент отримає лист про розбіжність із контрагентом, визначить спірну транзакцію, перевірить економіку угоди проти внутрішнього реєстру протягом 30 секунд і складе відповідь, переклавши внутрішні ID угод назад у номенклатуру брокера — без участі людини». Кожне слово в цьому реченні стає окремою перевіркою: чи знайшов правильний ID транзакції, чи звернувся до реєстру перед тим, як писати відповідь, чи зробив зворотне мапування ID.
Другий приклад — булева перевірка замість оцінки «наскільки корисна відповідь»: Did the agent verify the account ID before calling the refund tool? (Yes/No). Третій — відповідь може пройти всі перевірки на якість тексту й все одно бути провалом для продакшну, якщо зайняла 40 секунд, зробила дванадцять зайвих викликів тулів і коштує 60 центів за запит. Тому Google пропонує оцінювати не лише фінальний текст, а latency, споживання токенів (prompt, reasoning, completion окремо), вартість API та кількість викликів тулів одночасно.
Як розгортати перевірку по днях
Підхід побудований як поступовий перехід, а не разовий запуск складної системи:
- День 0: розбити CUJ на набір тестових сценаріїв і прогнати їх через симулятор користувача (ADK user simulations) із заданою персоною — наприклад, нетерплячий аналітик, що дає неповний номер тикета, або розробник із багатоскладовим питанням про дебаг. Прочитати перші 5-20 трейсів «червоною ручкою»: де агент зависає, обирає не той тул, починає розтікатися.
- День 1: перетворити ці нотатки на автоматизовані перевірки й тюнити одну змінну за раз.
- День 2: коли pass rate стабілізувався, закріпити перевірки як gate у CI/CD pull request.
Чотири типи перевірок і де помиляються команди
Джерело виділяє unit-тести, детерміновані метрики, LLM-as-a-judge рубрики (булеві, Adaptive Rubrics) та інтеграційні тести — і наполягає, що жоден з них не замінює інші. Типова помилка під час налагодження: видалити «шумний» тест або підмінити приклади запитів між прогонами. Це робить baseline непорівнюваним — неможливо сказати, чи агент покращився, чи просто змінився набір тестів. Правило джерела: тримати золотий набір даних незмінним під час тюнінгу, змінювати одну змінну за раз і видаляти тест лише тоді, коли сама вимога справді змінилася.
Інша поширена помилка — намагатись з першого дня побудувати складну автоматичну систему оцінки. Джерело прямо каже: будь-яка повторювана перевірка, навіть проста, краща за вибіркові ручні перевірки або їхню відсутність узагалі.
Що перевірити, перш ніж довіряти звіту
Перехід на різні оркестраційні фреймворки часто змушує команди переписувати весь набір тестів із нуля, бо фреймворки по-різному розмічають виклики тулів, кроки й токени у трейсах OpenTelemetry. Рішення — стандартизувати трейси за специфікацією OpenInference: це відв'язує оцінку від конкретного фреймворку, і agent-eval toolkit підтримує це нативно.
Після кожного прогону toolkit будує інтерактивний HTML-звіт, де булеві pass/fail-метрики стоять поряд із latency, споживанням токенів, витратами на API, використанням кешу та детальними шляхами викликів тулів. Звіт також включає автоматичний root-cause аналіз від Gemini для провалених ходів діалогу — він вказує на конкретну директиву промпту чи параметр, що спричинив збій, і саме це варто перевірити перед тим, як правити промпт навмання.