Агенти переписали 300 тис. рядків гри за $4000
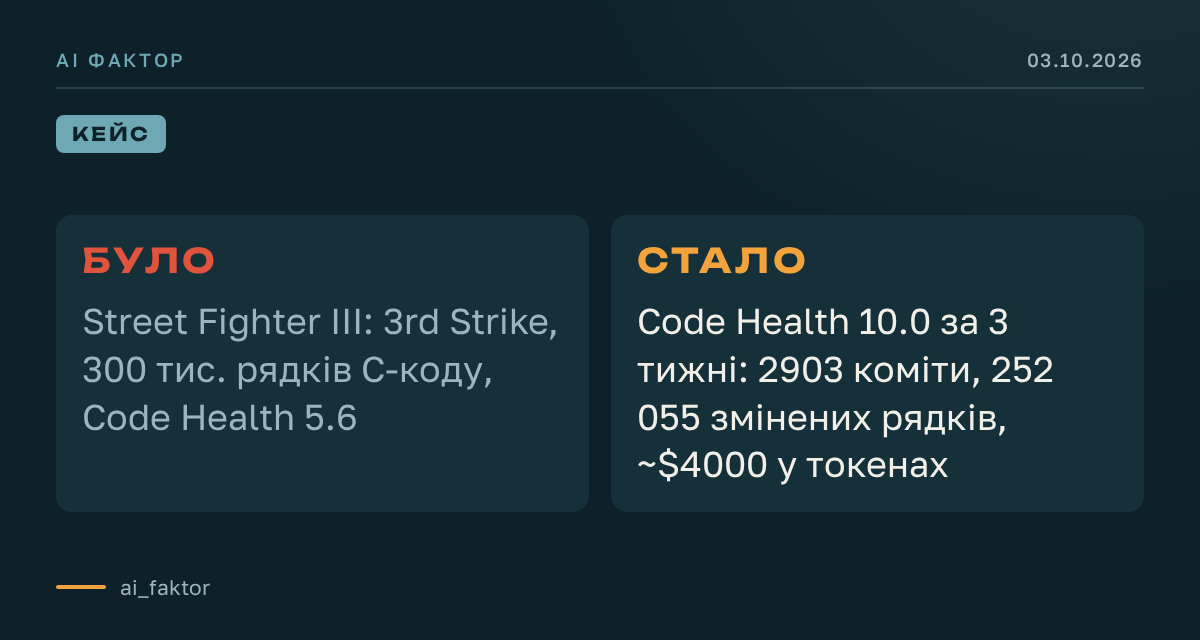
CodeScene та агенти на Claude Opus за три тижні перетворили 300 тис. рядків C-коду гри Street Fighter III: 3rd Strike — 2903 коміти, 252 055 змінених рядків, Code Health зросла з 5.6 до 10.0 за ~$4000 у токенах. Зміни злили в main через 54 pull request'и.
Точність перевіряв replay-trace harness, що звіряв кадри гри до і після зміни — такого "оракула" немає в більшості legacy-систем. Агенти самі склали плейбук із 22 рецептів рефакторингу. Заявлені 70% менше дефектів і 45% менше токенів — лише проекції з попередніх досліджень CodeScene, а не результат цього кейсу.
Два механізми, що тримали процес під контролем
Команда CodeScene опублікувала кейс, де агенти на базі ШІ рефакторили 300 тис. рядків коду гри Street Fighter III: 3rd Strike — відкритої декомпіляції, 726 файлів. Засновник CodeScene Адам Торнхілл, автор книги «Your Code as a Crime Scene», написав, що за три десятиліття роботи з великими системами це перший раз, коли він побачив те, що назвав «надлюдською продуктивністю ШІ в масштабі».
Роботу тримали два механізми. Перший — сигнал якості: CodeHealth MCP Server давав агентам детермінований бал, який вони оптимізували й за яким оцінювали, чи зміна справді покращила код. Другий — перевірка коректності: replay-trace harness порівнював хеш стану гри кадр за кадром до і після зміни, тож поведінку гри перевіряли після кожної правки.
Плейбук із 22 рецептів — не шаблон, а те, що з'явилося по дорозі
Замість застосування готового каталогу прийомів агенти накопичували власний плейбук і завершили з 22 рецептами й 82 підтримуючими нотатками. Серед них — звичні трансформації, як Extract Function та Guard Clauses, але також рецепти, специфічні саме для цього коду: Shared Index Range для циклів, що відрізняються лише стартом і кінцем діапазону, Action Parameter для дубльованих керуючих конструкцій, які відрізняються переважно тим, яку функцію викликають, і Uniform Step Table — перетворення різнорідних викликів у табличну диспетчеризацію.
Невдалі спроби теж фіксували — включно з трансформаціями, які погіршували Code Health. Це дало команді матеріал для того, щоб побачити, де прийом не працює, а не лише де працює.
Чому вибір моделі вплинув на результат
Команда зупинилася на Claude Opus для основного обсягу роботи: за її звітом, Claude Code з Opus значно краще за Codex із Sol фіксував і документував патерни, що виникали під час рефакторингу. Файли, які обробляли менші моделі, часто виходили на плато — здавалося, що модель досягає локального оптимуму, подолати який вже не могла.
Де метод спрацював завдяки грі — і чому це не універсально
Replay-trace harness працював саме тому, що декомпільована гра дає детермінований повтор кадр за кадром. У більшості legacy-систем такого «оракула» немає — і це одна з причин, чому рефакторинг таких систем ризикований сам по собі. Торнхілл пише, що автоматизовані тести й перевірки еквівалентності — абсолютно необхідні засоби захисту, а це покладає тягар саме на те, чого нездоровим кодовим базам зазвичай не вистачає. Команда сама це підтвердила на етапі вибору: вони розглядали кодову базу морського ліцензування Gov.UK, з якою один з авторів уже працював, але вона виявилася занадто «здоровою», щоб бути корисною для подальшого дослідження, і зрештою обрали гру — зокрема тому, що самі є її користувачами.
Реакція практиків розділилася не щодо факту результату, а щодо умов, які його створили. Частина погодилася, що звірка по кадрах — вища планка, ніж зелений набір тестів. Інші запитували про масштаб: чи код злили в основну гілку, чи це експеримент на відкритому коді, а не на продукційній системі, яка заробляє гроші (автор відповів, що злили в main форку через 54 pull request'и). Окремо ставили питання, чи виміряне це можливості моделі чи властивості самого harness-у, оскільки архітектура коду лишилася неоціненою — і код може виглядати «здоровим», а фундаментальні проблеми виринути пізніше.
Нефункціональні характеристики гри — частота кадрів, пам'ять, затримка введення — не перевірялися: автори визнали, що для цього залучають профільного фахівця. Також не встановлено остаточно, чи harness, що запускався як pre-commit hook, ловив тонкі регресії в таймінгу кадрів, бо частину помилок виправляли без фіксації факту збою.
Наступний крок — дослідження з Lund University, де студенти реалізовуватимуть нові функції в обох версіях коду (з Code Health 5.6 і 10.0) за допомогою провідних моделей і порівнюватимуть вартість і якість; саме з цього дослідження мають з'явитися цифри про скорочення дефектів і витрати токенів, заявлені поки лише як прогноз на основі попередніх досліджень CodeScene.