Як Conde Nast прискорив пошук у 140 000 відео
Conde Nast (Vogue, GQ, Vanity Fair, Wired) мав архів 140 000+ відео — редактори шукали кліпи в середньому 250 хвилин, орієнтуючись лише на назви файлів. З AWS GenAIIC компанія побудувала мультимодальний пошук на Amazon Bedrock: TwelveLabs Marengo індексує відео за транскриптом, зображенням і звуком, а Amazon OpenSearch Service шукає за природномовними запитами з точними таймкодами.
Система розуміє зміст запиту, а не збіг слів у файлі, і не залежить від памʼяті конкретного редактора.
П'ять сценаріїв пошуку, яких раніше не було
Метадані на кшталт назви файлу не відповідали на запити, якими реально користуються редактори. Система розуміє природномовні формулювання, наприклад «beginner yoga content with calming backgrounds» або «celebrity interview about sustainability», і повертає релевантні кліпи з точними таймкодами.
Крім тексту, є пошук за зображенням: користувач завантажує референсне фото — система знаходить візуально схожий контент у всьому архіві. Пошук також толерантний до одруків і орієнтується на зміст запиту, а не на точний збіг слів, а результат вказує не на весь файл, а на конкретний момент усередині відео.
Як це працює технічно: два незалежні контури
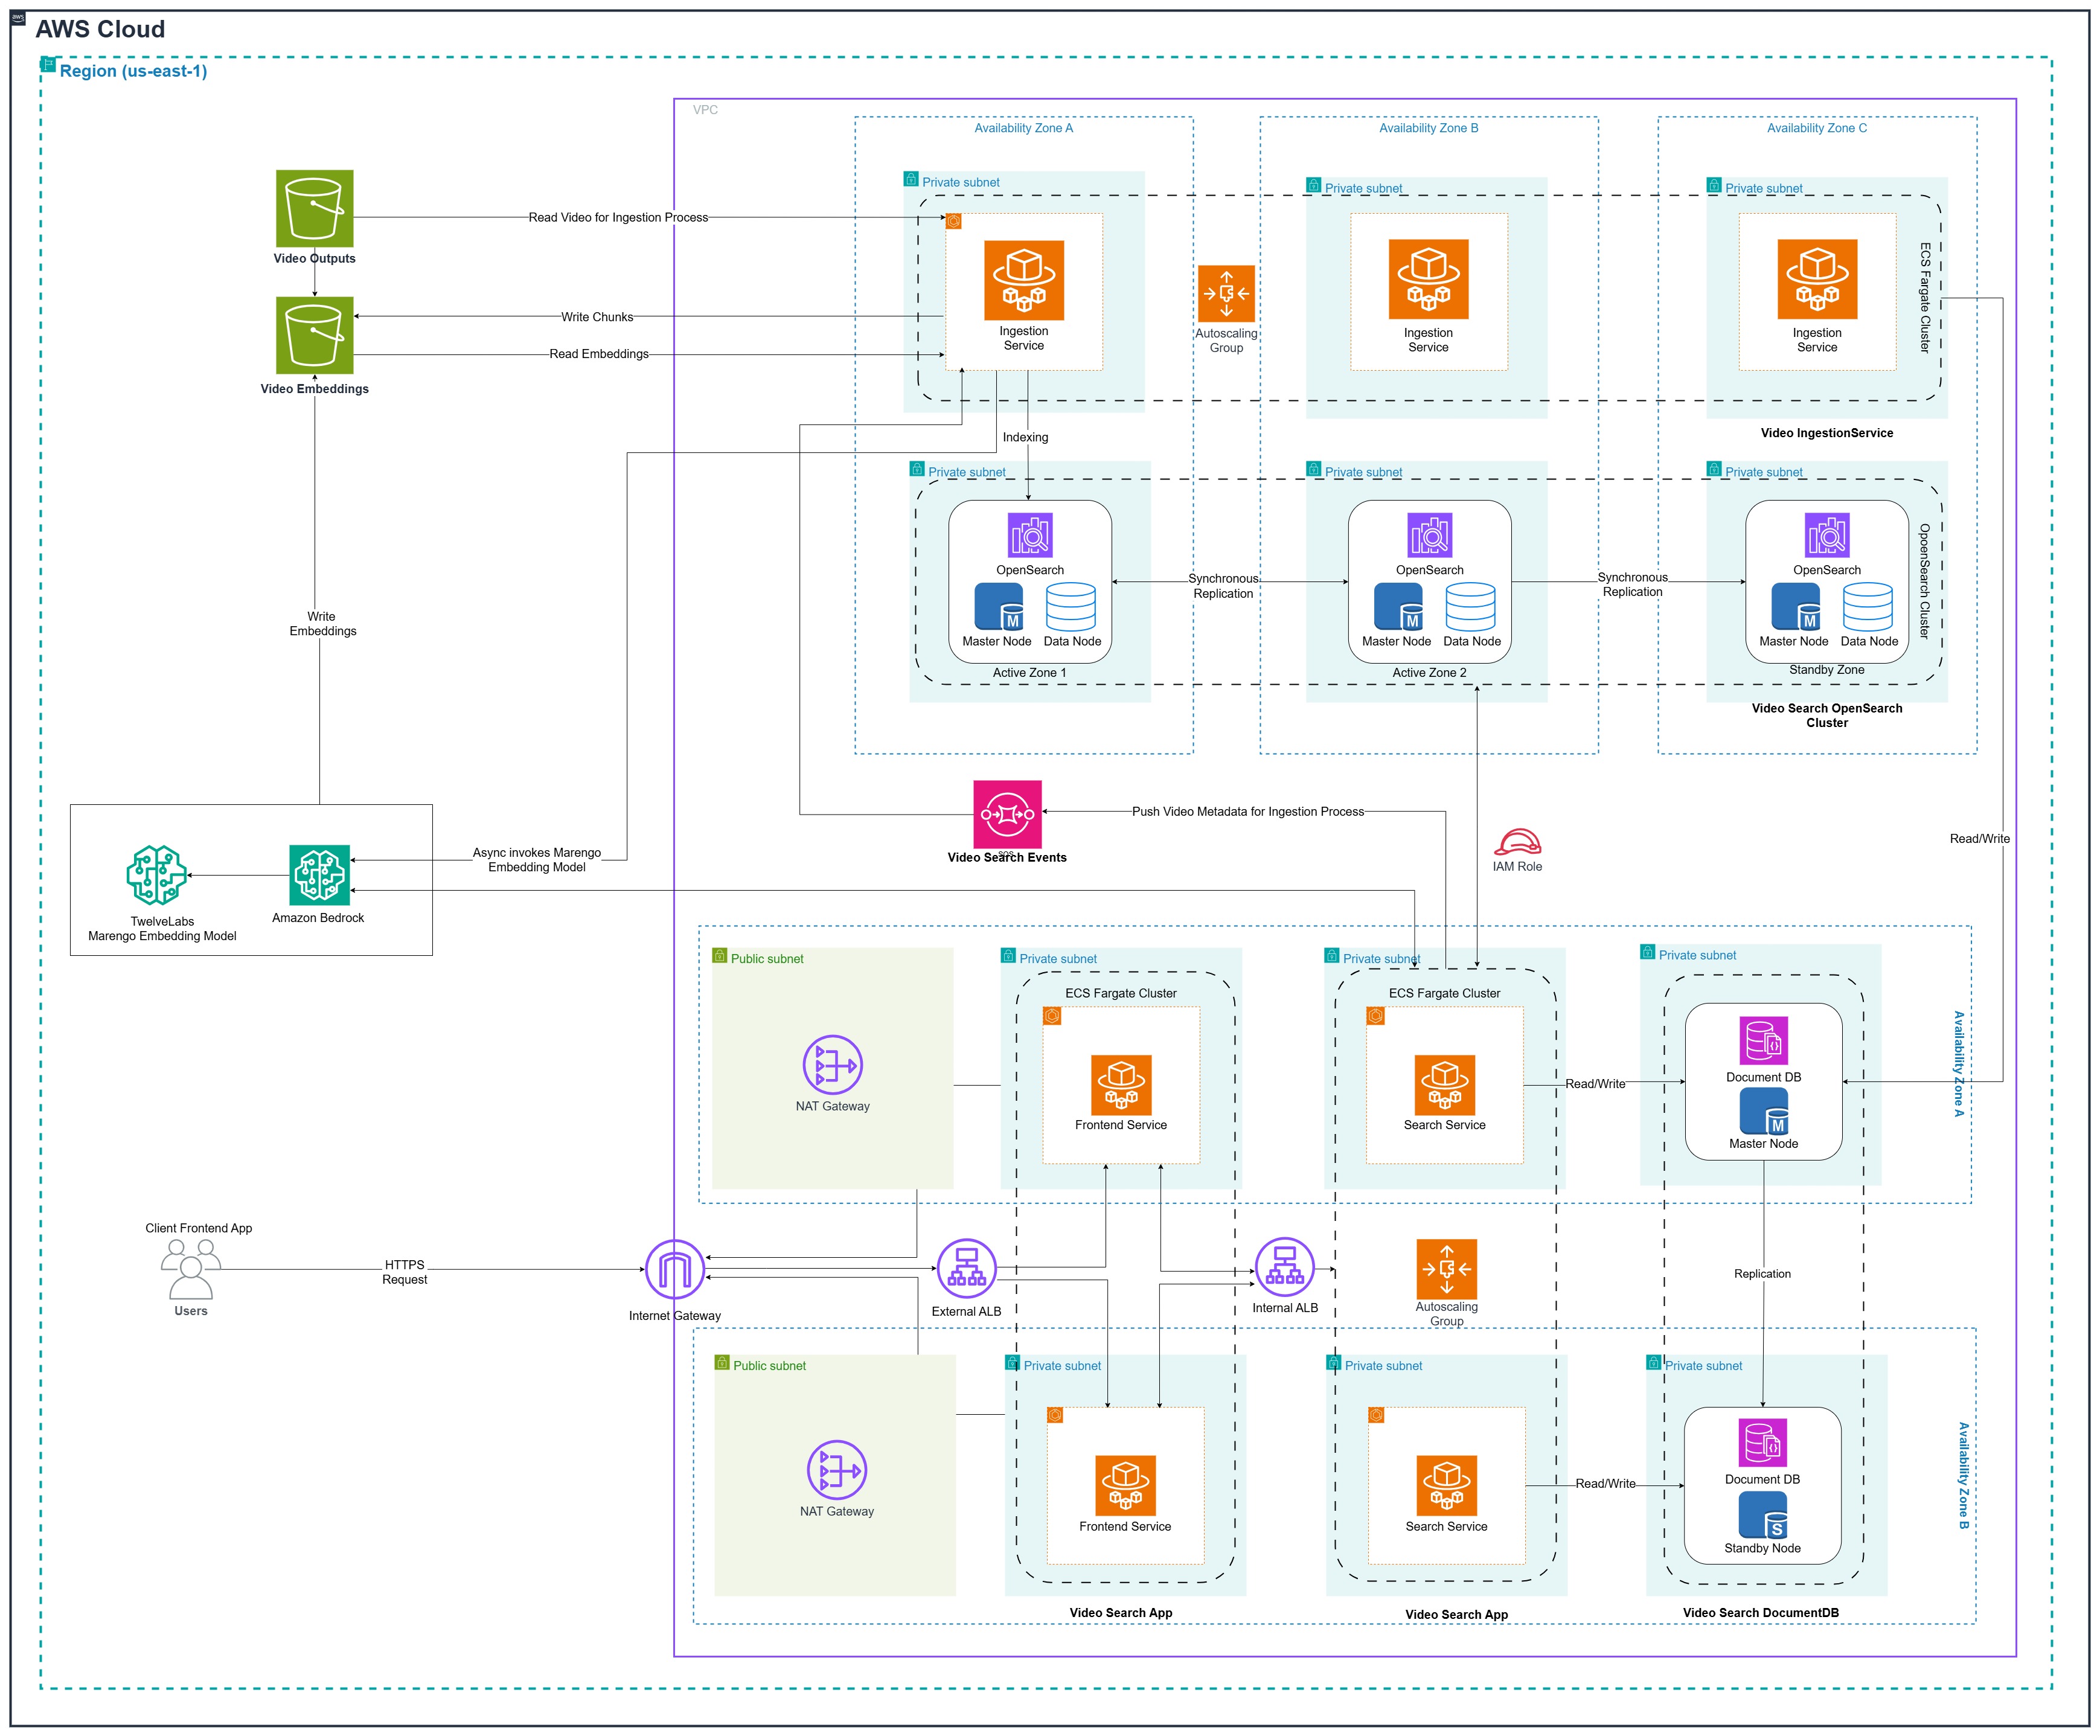
Архітектура розділена на контур індексації (асинхронний) і контур обслуговування запитів (синхронний) — кожен масштабується й оновлюється окремо. Це виявилось критичним під час первинного завантаження в архів понад 140 000 наявних відео.
Контур індексації обробляє кожне нове відео за такою послідовністю:
- відео завантажується в сховище Amazon S3;
- подія завантаження запускає обробку і передає метадані у конвеєр;
- сервіс перевіряє формат, тривалість і роздільність файлу;
- відео ділиться на сегменти, які паралельно обробляються на Amazon ECS з AWS Fargate;
- кожен сегмент проходить через модель TwelveLabs Marengo на Amazon Bedrock, яка одночасно кодує зображення, звук і транскрипт в один вектор;
- готові вектори зберігаються в Amazon S3 та індексуються в Amazon OpenSearch Service.
Коли редактор надсилає запит, система перетворює його на вектор, шукає найближчі збіги в OpenSearch (k-NN), а метадані — назву, мініатюру — підтягує з Amazon DocumentDB. Доступ до моделі контролюється через AWS IAM, мережа ізольована через Amazon VPC, дії логуються через AWS CloudTrail.
Що довелося підбирати експериментально
Довжину сегмента, на які ділиться відео перед створенням векторів, команда підбирала ітеративно за результатами тестів на реальних редакторських запитах: короткі сегменти губили контекст, довгі — розмивали семантичний сигнал.
Генерація векторів працює асинхронно через AWS Step Functions — синхронні виклики моделі створили б вузьке місце при обробці понад 140 000 файлів. Мультизонну відмовостійкість команда закладала одразу: OpenSearch реплікується синхронно між трьома зонами доступності, DocumentDB має резервний вузол у другій зоні. Обґрунтування команди — вбудувати це на старті дешевше, ніж дороблювати пізніше, бо навіть короткий збій напряму означає втрачену продуктивність редакції.
Перед побудовою системи команда інтерв'ювала редакторів, щоб зрозуміти, якими словами вони описують контент — це визначило рівень абстракції для семантичного пошуку. Без цього кроку система ризикувала оптимізуватися під запити, які ніхто насправді не вводить.
Результати й межі застосування
За вимірюваннями воркшопу з оцінки ефекту, який Condé Nast провів у травні 2026 року, час пошуку скоротився на 99,2% — з 250 до приблизно 2 хвилин на завдання, а обсяг ручного перегляду відео зменшився більш ніж на 90%. За оцінкою на основі того ж воркшопу, річна економія на операційних витратах становить приблизно $800 000. Пошук також підняв на поверхню відео, які раніше лежали незатребуваними в архіві, бо жодне ключове слово в назві не пов'язувало їх із запитами редакторів.
«Команда AWS разом із фахівцями GenAI та TwelveLabs допомогла нам чітко й стисло пояснити бізнес-кейс. Я з оптимізмом дивлюся на подальший прогрес у наших робочих процесах», — Біллі Кінлі, Global Senior Director, Creative Optimization, Condé Nast.
За словами авторів рішення, підхід застосовний для організацій із великими відеоархівами — телерадіомовників, стрімінгових сервісів, спортивних ліг, корпоративних медіакоманд; розділена архітектура дозволяє замінювати модель векторизації та типи контенту в міру розвитку технологій. Рішення працює в продакшені шість місяців, і пошук лишався доступним, поки контур індексації переобробляв дані заднім числом. Дату запуску проєкту й вартість впровадження матеріал не наводить.