BMW автоматизувала аномалії витрат у 14 000 хмарних акаунтів
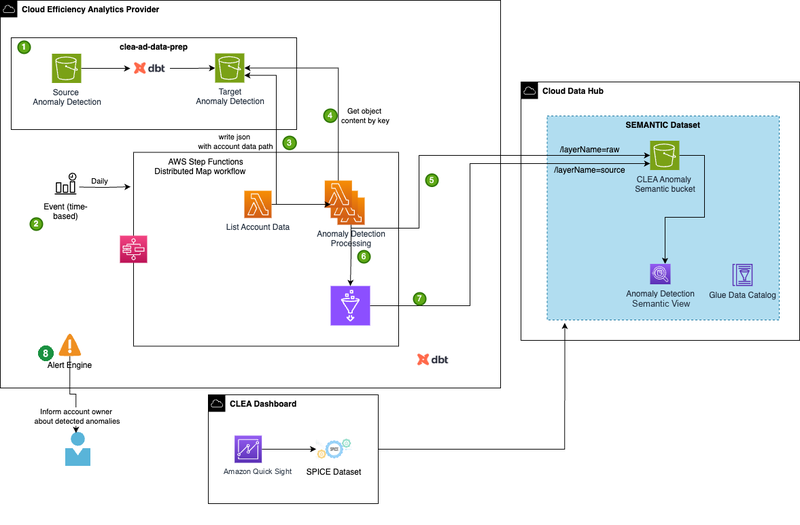
CLEA від BMW Group і Reply щодня перевіряє 14 000 хмарних акаунтів і обробляє близько 3 млрд рядків біллінгових даних на місяць. Prophet (бібліотека Meta) прогнозує витрати на основі 365 днів історії для кожної пари акаунт-сервіс; до 500 паралельних Lambda-функцій завершують прогін за 20 хвилин і коштують 50 доларів на місяць.
Раніше BMW бачила витрати лише в дашбордах Quick Sight, які треба відкривати самому. Тепер лист про перевищення йде власнику акаунта автоматично, а поріг підлаштовується під акаунт: 40% відхилення за замовчуванням, 60% для мінливих сервісів (EC2, Glue, Athena).
Як система відрізняє нормальне зростання від аномалії
Модель Prophet тренується на 365 днях історії витрат окремо для кожної пари акаунт-сервіс, з адитивною сезонністю. Поріг спрацювання не єдиний для всієї компанії — він підлаштовується під траєкторію конкретного акаунта: той, що щомісяця нарощує використання, отримує інший «коридор» очікуваних витрат, ніж стабільний.
У підходу є зворотний бік. Якщо витрати акаунта стало підскочили — наприклад через розширення робочого навантаження, — CLEA позначить аномалію лише перші кілька днів. Далі модель «звикає» до нового рівня протягом вікна тренування і перестає бачити відхилення. Метод найкраще ловить одноразові сплески, а не поступові структурні зміни витрат.
Перш ніж дані потрапляють у прогноз, CLEA відсіює сервіси із середніми витратами нижче $0,10 за останні три дні та сервіси, для яких накопичено менш як 10 днів історії, — для них прогноз ненадійний.
Кілька рівнів фільтрів перед тим, як лист піде власнику
Відхилення від прогнозу саме по собі — ще не привід писати листа. Спочатку діє загальний поріг у 40% відхилення. Але відсоток без прив'язки до суми оманливий: акаунт, що звично витрачає $0,10 на сервіс, а потім раптом $1, формально дає стрибок на 900%, хоча в грошах це нічого не важить.
Тому CLEA ділить акаунти на чотири кластери за середніми витратами за останні три місяці, і для кожного кластера встановлює свій мінімальний грошовий поріг: понад 40% відхилення аномалія має ще й «набрати» достатню суму саме для свого кластера.
Для сервісів, які за природою використання дають нерівномірні витрати навіть у штатному режимі — AWS Glue, Amazon Athena, Amazon EC2, — стандартний поріг 40% давав забагато хибних спрацювань, тож для них його підняли до 60%. Окремо є список акаунтів зі зниженою чутливістю: команди із заздалегідь відомими нестабільними навантаженнями самі попросили менше сповіщень, і для них поріг утричі вищий за стандартний.
Що бачить власник акаунта і як перевірити причину
Лист-сповіщення містить весь контекст для рішення, а не лише факт перевищення: ID та назву акаунта, власників і ієрархію підрозділу з метаданих BMW Group, назву сервісу, дату й тривалість аномалії, очікувані витрати проти фактичних, абсолютне й відсоткове відхилення та сукупний вплив за всіма одночасними аномаліями на акаунті. До листа додається Excel-таблиця з повними даними.
У прикладі з матеріалу лист повідомляє про перевищення на $1775,13: очікувані витрати на Amazon EC2 становили $809,30, фактичні — $2584,43, відхилення — 219,34% за один день. Лист прямо попереджає, що аномалії виявляються за сплесками витрат і можуть включати хибні спрацювання.
Далі власник акаунта сам розслідує причину — без залучення платформної команди. У дашборді Amazon QuickSight можна відкрити аномалію і побачити два графіки: витрати за операціями і за типами використання. У наведеному в матеріалі кейсі так встановили, що сплеск із приблизно $900 до $2600 за день спричинила операція RunInstances, а конкретний винуватець — інстанс типу EUC1-BoxUsage:g6.48xlarge. За спостереженнями команди, операція та тип використання разом пояснюють більшість причин аномалій, тому дашборд починається саме з цих двох розрізів.
Де закінчується автоматика
CLEA бачить операції, типи використання і суми, але не бачить наміру: чи заплановане це зростання витрат (запуск нового навантаження, міграція) чи ні — знає тільки власник акаунта. Тому пороги фільтрів команда не намагається «довиправити» алгоритмічно: їх калібрують за фідбеком користувачів, який збирають через кнопку в застосунку та заклик до дії в кожному листі.
Технічно весь цикл — оркестрація в AWS Step Functions з розподіленою мапою на до 500 паралельних Lambda-функцій, толерантність до збою встановлена на рівні 5 акаунтів із приблизно 14 000, тобто потрібна успішність запуску 99,96%. У планах команди — інтеграція сповіщень з ITSM, щоб власники отримували тікети у звичному робочому процесі замість листів; портал самообслуговування, де власники самі виставлятимуть поріг чутливості для своїх акаунтів; агентний ендпоінт, який автоматично пояснюватиме ймовірну причину сплеску; та інтеграція з AWS CloudTrail, яка показуватиме, який користувач чи роль налаштували сервіс, що спричинив зростання витрат.