AWS генерує синтетичні дані для безпеки на виробництві
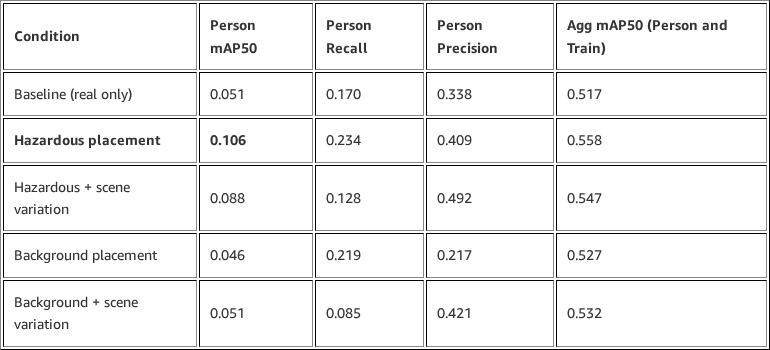
AWS показала конвеєр на SageMaker AI: модель Qwen-Image-Edit-2509 вставляє синтетичних людей у реальні фото техніки (трактори, потяги, кар'єрна техніка), а Amazon Rekognition автоматично розмічає межі людини. Результат — до 160% приросту точності виявлення людей поруч із технікою, без ручної розмітки і небезпечних фотозйомок.
Ручна розмітка коштує $3–5 за фото, а найнебезпечніші сценарії — людина в мертвій зоні, дитина біля техніки — найрідші в реальних датасетах. AWS з'ясувала: розміщення людей саме в небезпечних позиціях, а не на фоні, подвоює точність.
Як влаштований конвеєр
Рішення AWS працює у два етапи. Спершу дифузійна модель Qwen-Image-Edit-2509, розгорнута на інстансі ml.g5.12xlarge (чотири GPU NVIDIA A10G, 96 ГБ відеопам'яті сумарно), редагує реальні фотографії техніки — вставляє в них людей, зберігаючи фон, освітлення й масштаб. На генерацію одного зображення йде близько 166 секунд. Потім Amazon Rekognition через API DetectLabels автоматично визначає межі вставлених людей із мінімальним порогом впевненості 80% — це замінює ручну розмітку.
Для тестів AWS узяла підмножину відкритого датасету OpenImages як аналог клієнтських даних про важку техніку: близько 3200 реальних фото потягів і до 1000 синтетичних зображень із доданими людьми. Тестовий набір складався лише з реальних фото, без синтетики.
Що показали експерименти
Головний висновок: важливо не «різноманітити» сцену (погода, час доби), а саме те, де саме опиняється людина. Розміщення людей у небезпечних позиціях — на коліях, на техніці, у зоні руху — подвоїло точність виявлення людей (mAP50 зросла з 0,051 до 0,106) порівняно з базовою моделлю без синтетики. Розміщення людей просто на фоні сцени, навпаки, трохи погіршило результат.
Кількість синтетичних зображень — теж окремий параметр, який треба підбирати, а не максимізувати. Найкращий результат AWS отримала на позначці 750 синтетичних фото (приріст точності 160%, з 0,051 до 0,134); далі якість почала падати через накопичення артефактів генерації — спотворені обличчя, пересвітлення.
Розмір моделі теж має відповідати обсягу даних. Серед п'яти варіантів YOLO11 найкращий сукупний результат (mAP50 0,604) і найвищу повноту виявлення людей (0,340) показала модель середнього розміру — вона подвоїла recall порівняно з базовою (з 17% до 34%). Найбільша модель (57 млн параметрів) на такому обсязі даних (близько 4200 зображень) працювала гірше за меншу модель із синтетикою — даних не вистачило для її регуляризації. При цьому точність виявлення самої техніки не постраждала і трималась у діапазоні 0,73–0,79 mAP50 у всіх сценаріях.
Навіщо це бізнесу
Ручна розмітка коштує $3–5 за фото, а команди розмітників обробляють приблизно 2000 зображень на день — і це все одно не вирішує головну проблему: найнебезпечніші сценарії (людина в мертвій зоні, дитина біля техніки) або взагалі не трапляються в реальних даних, або їх небезпечно й неетично інсценувати для зйомки. Синтетичний конвеєр знімає обидва обмеження одразу.
За оцінкою AWS, це скорочує шлях від виявлення прогалини в даних до готового до навчання датасету з тижнів-місяців до годин: інфраструктуру розгортають один раз, а для нового сценарію чи галузі (будівництво, склади, сільгосптехніка) досить змінити текстовий промпт. Код пайплайна викладено у відкритому репозиторії на GitHub.
Точної вартості самого розгортання (оренда GPU-інстансів, виклики Rekognition) та тарифів на ці сервіси в матеріалі не наведено.