AWS запропонувала стискати контекст у RAG
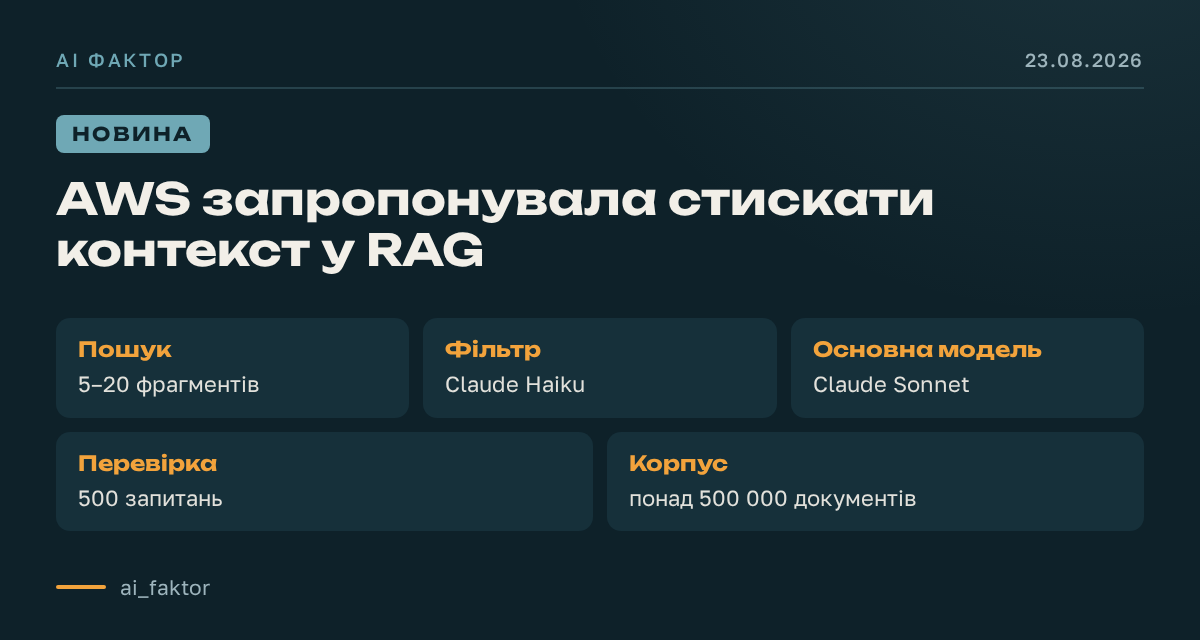
У RAG-схемі для Amazon Bedrock після пошуку Claude Haiku відбирає лише дослівні уривки, релевантні запиту. Далі Claude Sonnet формує відповідь зі скороченого контексту. Обидва виклики виконує AWS Lambda через Converse API. Звичайний пошук повертає 5–20 фрагментів — часто це кілька тисяч вхідних токенів на запит.
AWS перевірила підхід на понад 500 000 документах дев’яти типів і 500 запитаннях у десяти категоріях. Якість оцінювали за правильністю, повнотою, точністю цитувань і лаконічністю. Менше нерелевантного контексту знижує витрати на основну модель і звужує простір для галюцинацій, але результат залежить від корпусу та запитів.
Який результат показав тест AWS
Додавання компресії скоротило вартість запиту проти базового сценарію на 33% і передавало Claude Sonnet у 8,6 раза менше токенів. Поєднання переранжування зі стисканням дало 36% економії та зменшило контекст у 10,1 раза.
Правильність відповідей в обох оптимізованих варіантах залишилася в межах 0,07 бала від базового результату за шкалою 1–5. Водночас повнота й точність цитувань трохи знизилися, а лаконічність дещо зросла. Частка відповідей із принаймні одним твердженням, не підтвердженим еталоном, становила 51% без компресії, 44% із компресією та 38% із переранжуванням і компресією.
На складних запитах вигода була меншою: економія від компресії знизилася з 37% для типових запитів до 26%, а для зв’язки з переранжуванням — із 40% до 30%. AWS застерігає, що це результати одного корпусу, домену та розподілу запитів.
За рахунок чого виникає економія
Дешевша модель читає знайдені фрагменти разом із запитом, але не переказує їх. Інструкція вимагає копіювати лише релевантні дослівні уривки, не перефразовувати текст і залишати достатньо оточення для коректних цитат. Виклик компресії працює з температурою 0.0, щоб вилучення було детермінованим.
Ефект залежить від співвідношення цін малої та основної моделей і коефіцієнта стискання. Додатковий виклик сам коштує грошей, тому схема вигідна, коли контекст великий, основна модель відносно дорога, а значну частину знайденого тексту можна прибрати без втрати якості.
Де підхід має практичний сенс
AWS радить розглядати прототип, якщо більшість умов виконуються:
- середній знайдений контекст перевищує приблизно 5 000 токенів;
- зменшення контексту у 3–10 разів дає відчутну економію на вхідних токенах основної моделі;
- переважають вузькі питання, а не запити на узагальнення всього масиву;
- затримка допускає ще один модельний виклик — від кількох сотень мілісекунд до приблизно секунди;
- є набір запитів, на якому можна порівняти якість до і після компресії.
Серед придатних сценаріїв AWS називає помічників із комплаєнсу й політик у фінансах, страхуванні, медицині та комунальних послугах; клієнтську підтримку над великою базою знань; внутрішні помічники для регламентів і вікі; фінансові дослідження та аналіз дзвінків про результати. Наприклад, у регуляторних матеріалах пошук може повертати 8 000–15 000 токенів, хоча аналітику потрібен один пункт.
Умови впровадження та відкриті питання
Потрібні активний обліковий запис AWS, IAM-роль і політики доступу для Lambda, а також доступ у своєму регіоні Amazon Bedrock до обох моделей каскаду. Пара не обмежена Claude: AWS також наводить Amazon Nova Micro з Amazon Nova Pro. Наявність моделей залежить від регіону.
Додатковий виклик збільшує затримку, хоча частину часу можна повернути завдяки коротшому фінальному контексту. Для чатів із вимогою відповіді менш ніж за секунду й невеликим контекстом схема може не підійти; AWS пропонує натомість оцінити кешування промптів та Intelligent Prompt Routing.
Фіксованої ціни чи гарантованої економії джерело не дає. Перед запуском AWS радить взяти знеособлені реальні запити, прогнати базовий і стиснений варіанти на однакових результатах пошуку, перевірити правильність, повноту, цитування й відповідність доказам та встановити власні пороги прийнятності.