AI-медик масштабується через архітектуру даних
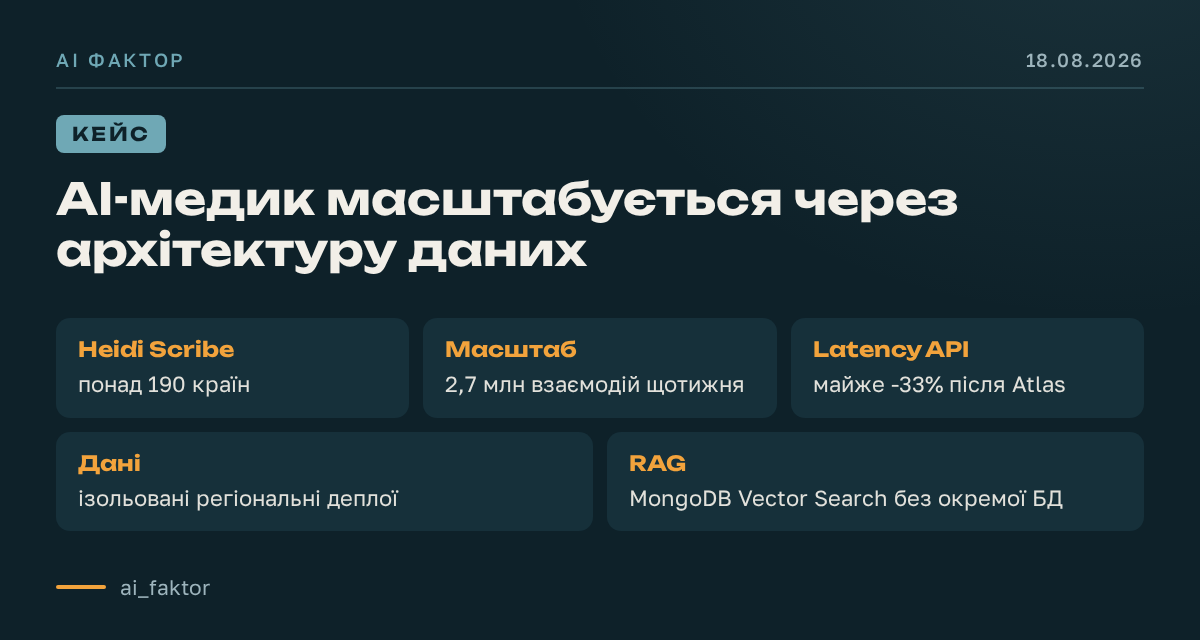
Австралійська Heidi розгорнула Heidi Scribe у понад 190 країнах: сервіс автоматизує адмінроботу лікарів і підтримує близько 2,7 млн взаємодій із пацієнтами щотижня. Для цього компанія тримає ізольовані регіональні production-деплої з власними MongoDB Atlas-кластерами, compute і ключами, щоб дані лишалися в межах APP, GDPR, APPI чи HIPAA.
Ключ не лише в моделі: CTO Yu Liu каже, що модель — приблизно 20% системи, а решта тримається на data architecture. Перехід на Atlas знизив latency ключових API майже на 33%, а MongoDB Vector Search дозволяє RAG без окремої векторної БД.
Архітектура важливіша за саму модель
У кейсі Heidi головна думка не в тому, що AI Scribe працює у багатьох країнах. Корисніше інше: продукт для регульованої галузі не можна будувати так, ніби помилка моделі є лише незручністю. У медицині неправильний результат може вплинути на догляд за пацієнтом, тому система проєктується під перевірку, аудит і безпечні зміни.
Для бізнесу це означає: перед запуском AI-функції треба описати не тільки промпт і модель, а весь шлях даних. Які дані потрапили в систему, що модель побачила, що видала, що людина змінила після цього, і чи можна відновити цю історію через місяці. У Heidi така вимога закладена з першого дня, а не додається після масштабування.
Запит до постачальника: покажіть, як у вашій системі можна відновити одну сесію: вхідні дані, відповідь моделі, редагування людини, джерела та технічні зміни, які могли вплинути на результат.
Як це переноситься на фінанси, юристів і транспорт
Джерело прямо ставить поряд охорону здоров’я, фінансові послуги й транспорт: у всіх цих сферах AI-продукти обмежені комплаєнсом і повільнішими змінами. Другий приклад для бізнесу: фінансова команда запускає AI-помічника для роботи з документами. Проблема не лише в точності відповіді. Потрібно знати, з яких внутрішніх документів система брала фрагменти, чи не вийшли дані за дозволений регіон, і чи можна пояснити результат під час аудиту.
Третій приклад: транспортна компанія використовує AI у робочому процесі, де рішення спираються на операційні дані. Якщо система працює в кількох регіонах, обіцянки в договорі замалі. У Heidi кожен регіон є окремим production-деплоєм із власним кластером MongoDB Atlas, compute і ключем. Такий підхід зменшує ризик, що зміна або витік в одному місці зачепить інший регіон.
- Для фінансових сервісів перевіряйте, чи можна показати джерело кожного фрагмента, який потрапив у відповідь.
- Для юридичних і комплаєнс-команд перевіряйте, чи зберігається історія: що побачила модель, що вона видала, що змінила людина.
- Для транспортних і операційних процесів перевіряйте, чи зміни в базі, індексах і схемах проходять рев’ю так само, як код.
RAG працює тільки тоді, коли джерела контрольовані
У джерелі окремо пояснюється, що retrieval спочатку є задачею архітектури даних, а вже потім AI-задачею. У споживчому RAG система може шукати у відкритому вебі. У медицині Heidi бере дані з ліцензованих клінічних баз і враховує юрисдикцію: британський лікар отримує британські рекомендації, австралійський лікар — австралійські формуляри.
Для нетехнічного керівника тут є практичний тест. Якщо AI-помічник відповідає без прив’язки до конкретних джерел, країни, регіону або дозволеного набору документів, результат не можна вважати надійним для регульованої роботи. У Heidi цитування є жорсткою умовою: модель бачить тільки ті фрагменти, які вже пов’язані з записами-джерелами.
Формулювання для внутрішнього ТЗ: модель не має відповідати з пам’яті, якщо питання потребує джерела. Вона повинна працювати лише з дозволеними фрагментами, прив’язаними до записів, регіону та правил доступу.
Де підхід ламається і що перевіряти перед довірою
Підхід не працює, якщо команда спочатку запускає AI, а потім намагається «прикрутити» резидентність, аудит і масштабування. У джерелі є прямий урок: переподіл великої активної колекції є серйозною інженерною програмою, тоді як вибір shard key на початку є дизайн-зустріччю. Те саме стосується регіональної ізоляції: її простіше закласти в основу, ніж переробляти під HIPAA або інший режим після виходу на новий ринок.
Типова помилка — купити окрему векторну базу для RAG і отримати ще одну систему з власною безпекою та комплаєнсом. Heidi цього уникає: embeddings і vector indexes живуть у MongoDB Vector Search у тих самих регіонально ізольованих деплоях, що й решта даних. Інша помилка — вважати швидкість розробки протилежністю безпеці. У Heidi ризикові зміни проходять CI gates, canary releases, автоматичний rollback, рев’ю змін схем та індексів.
- Перед довірою до відповіді перевірте, які дані модель бачила.
- Перевірте, чи є джерела й цитати, а не лише впевнено написаний текст.
- Перевірте, чи людина редагувала результат і чи це редагування збережене.
- Перевірте, чи retrieval не може фізично перейти через межу регіону.
- Перевірте, чи зміни в базі, індексах і схемах проходять рев’ю та canary-перевірку.
Контрольне питання перед запуском: якщо через кілька місяців нам доведеться пояснити одну відповідь AI, чи зможемо ми показати вхідні дані, джерела, версію процесу, зміну людини й межі регіону?