OneAdvanced зібрала 50 ШІ-агентів у UK-хмарі
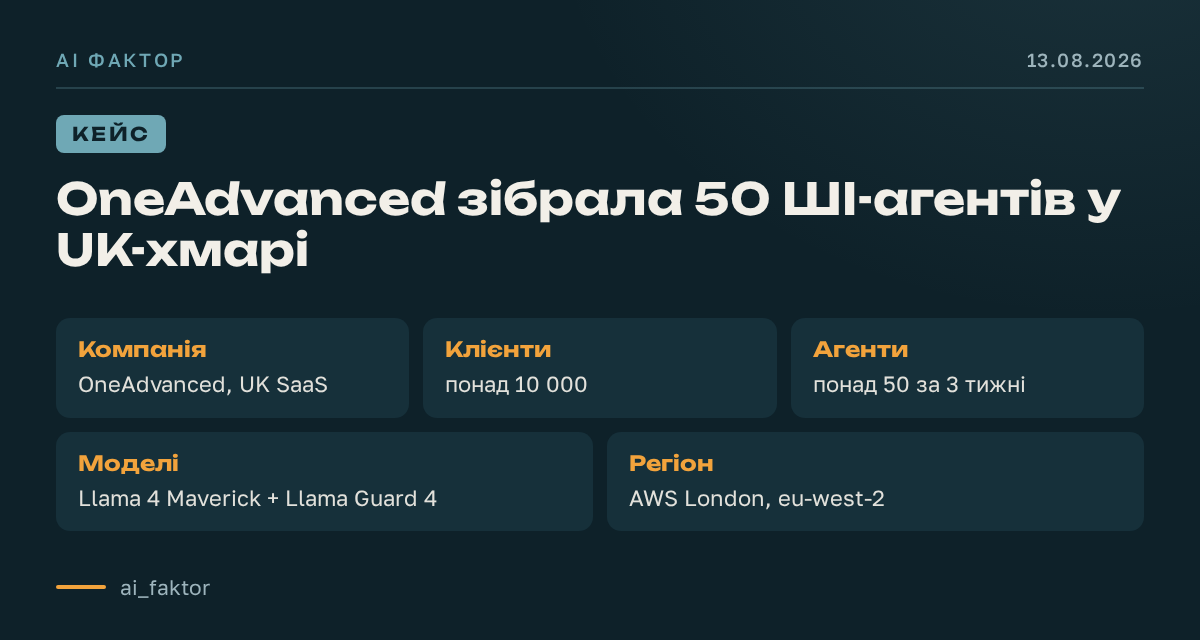
Британський SaaS-провайдер OneAdvanced, який обслуговує понад 10 000 клієнтів, розгорнув UK-sovereign AI-рішення на AWS: Llama 4 Maverick і Llama Guard 4 self-hosted на Amazon SageMaker AI у регіоні London. Моделі працюють через vLLM на p5.48xlarge, RAG побудований на Aurora PostgreSQL з pgvector, агенти — на Amazon ECS, конфігурації — у DynamoDB.
Причина такого підходу — вимога, щоб дані клієнтів із healthcare, legal, public sector та інших регульованих сфер не залишали Велику Британію. Компанія створила понад 50 спеціалізованих агентів за три тижні: для клінічних бюлетенів, юридичних задач, HR, маркетингу, логістики, порівняння документів і роботи з даними.
Чому вони не взяли готовий керований сервіс
OneAdvanced спочатку швидко перевірила ідею на Amazon Bedrock: за два тижні отримали чат, агента для запитів до UK statute law, інтеграцію зі Snowflake і побудову графіків. Але для клієнтів із регульованих секторів цього було недостатньо: дані мали залишатися в межах Великої Британії, а потрібні моделі Llama 4 Maverick і Llama Guard 4 на той момент не були доступні як керовані сервіси в UK-регіоні.
Тому компанія обрала self-hosted модель: Llama 4 Maverick FP8 і Llama Guard 4 працюють через vLLM на Amazon SageMaker AI в London region. Такий варіант складніший за підключення готового API, але дає контроль над тим, де працює модель, хто має доступ до інфраструктури і як обробляються запити.
Цей підхід має сенс не для кожної компанії. Він потрібен там, де є жорстка вимога до residency: patient records, legal case files, compliance documentation, public sector. Якщо такої вимоги немає, self-hosting може стати зайвою складністю: потрібні GPU-квоти, контейнери, доступ до ваг моделей, PostgreSQL із pgvector і команда, яка розуміє ML-фреймворки та оркестрацію.
Як працює запит усередині системи
Запит не йде одразу в основну модель. Спочатку Llama Guard 4 перевіряє введення користувача на harmful content. Лише після цього запит маршрутизується до потрібного агента на Amazon ECS. Далі агент може викликати інструменти, шукати в документах через pgvector і Amazon S3 або використовувати спеціалізовані сервіси на кшталт web search, якщо організація й користувач це дозволили.
- Користувач обирає агента з каталогу.
- Llama Guard 4 перевіряє запит перед основною інференс-моделлю.
- Strands agent отримує системний промпт, набір tools і, за потреби, structured input form.
- Якщо потрібні документи, агент викликає
Personal knowledge searchабоOrganization knowledge search. - Система повертає відповідь із посиланнями на документи, з яких взято фрагменти.
Для довгих документів OneAdvanced використовує RAG-пайплайн: файли завантажуються в personal або organization space на Amazon S3, конвертуються в markdown, діляться на chunks по 2,048 токени й індексуються в pgvector. Для embeddings використано intfloat/multilingual-e5-large-instruct. Якщо документ довший за chunk size, застосовується recursive summarization.
Що дають 50 агентів у бізнес-задачах
Цінність кейсу не в самій кількості агентів, а в тому, що кожен агент має вузьке призначення. У джерелі наведені приклади: Care Incident Response assistant, Clinical Safety Bulletin generator, performance review assistant, Document Comparison tool, operational scenario simulation, scheme of work generator for education, AWS Architect Agent. Це різні робочі ситуації, а не один універсальний чат для всього.
Наприклад, HR-команда може використовувати performance review assistant не як генератор красивого тексту, а як структурований сценарій оцінки. Юридична або compliance-команда може застосувати Document Comparison tool для порівняння документів. Освітній сценарій покриває scheme of work generator. У healthcare окремі агенти працюють із клінічними бюлетенями та інцидентами.
Окрема деталь: частина агентів працює в interview-style режимі. Вони не чекають, що користувач одразу напише ідеальний запит, а збирають контекст через запитання. У джерелі наведено формулювання: Question 1 of 3: What specific pain points does your AI solution aim to address? Для нетехнічних користувачів це практичніше, ніж порожнє поле чату.
Де межі й що перевіряти людині
Система не прибирає відповідальність із користувача. OneAdvanced спеціально показує, які документи були використані для відповіді. Це означає, що перед довірою до результату треба відкрити джерела й перевірити, чи справді відповідь спирається на релевантні фрагменти, а не на схожий за темою chunk.
- Перевірити, з якого простору взято дані: personal чи organization.
- Подивитися source references, які повернув retrieval tool.
- Оцінити, чи агент мав право використовувати web search у цьому запиті.
- Для таблиць і графіків перевірити, який tool викликався: spreadsheet query, Snowflake integration або chart creation.
- Для чутливих запитів перевірити, чи не заблокував би їх guard model і чи не потрібен людський перегляд.
Типова помилка при такій архітектурі: намагатися зробити одного універсального агента замість каталогу спеціалізованих. У OneAdvanced кожен агент має свій system prompt, tools і форму введення. Друга помилка: давати користувачам відкритий чат без структурованого збору контексту. Саме тому вони використовують form fields і @-синтаксис для підстановки значень у system prompts.
Ще одна межа — якість фільтрації. OneAdvanced замінила Llama Guard 3 на Llama Guard 4 після високої кількості false rejections. Це показує, що moderation layer сам потребує тестування, інакше бізнес-користувачі отримуватимуть відмови там, де запит робочий і допустимий.