Пам’ять стає новим стеком для AI-агентів
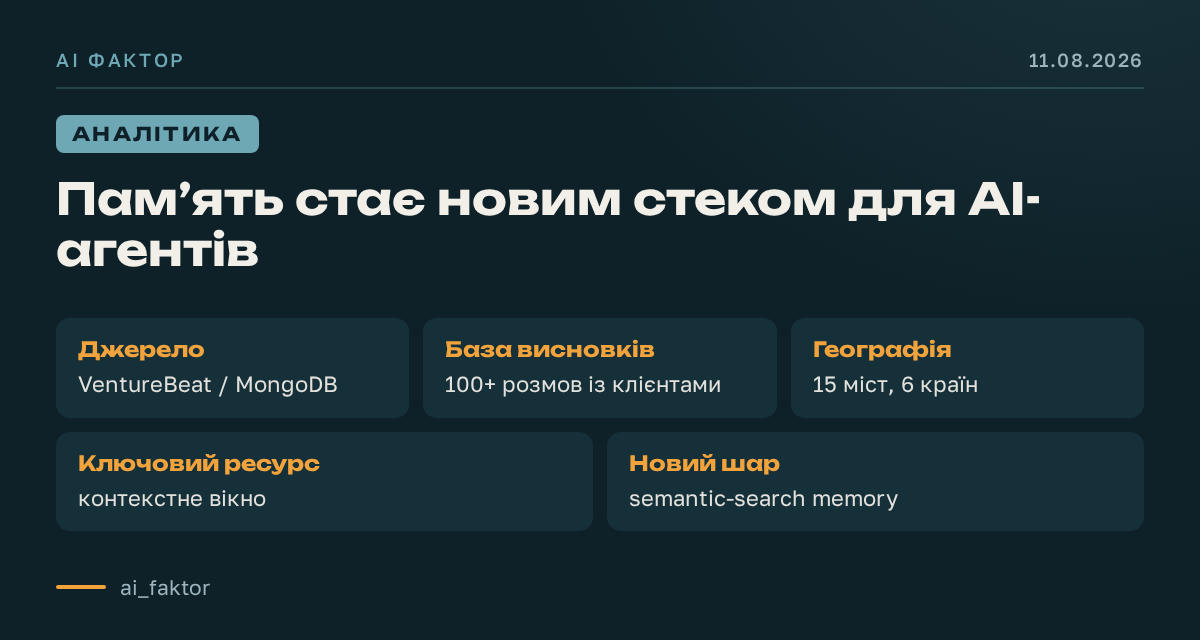
У спонсорованій колонці VentureBeat Field CTO MongoDB з AI Піт Джонсон описує висновки з понад 100 розмов із клієнтами у 15 містах шести країн у першій половині 2026 року: головне обмеження агентів — не кількість токенів, а контекстне вікно. Замість «token-maxxing» він пропонує постійну, доступну для запитів пам’ять поза моделлю.
Така пам’ять зберігає попередні відповіді, застосовує role-based access control і знаходить потрібне через semantic search. Типова схема: агент шукає схожу відповідь у пам’яті, легша open-weight модель оцінює, чи її достатньо, і лише за потреби запит іде до дорожчої генеративної моделі.
Чому розмова знову повернулась до баз даних
Колонка VentureBeat позначена як спонсорований матеріал MongoDB, а автором вказаний Піт Джонсон, Field CTO з AI у MongoDB. Він починає не з нової функції чи продуктового анонсу, а з різниці в зрілості ринку: бази даних індустрія будує приблизно 60 років, а AI-агентів у нинішньому розумінні — близько 18 місяців.
Звідси головний контекст: для агентів ще немає свого LAMP stack, тобто набору звичних, майже нудних архітектурних рішень, які команда бере за замовчуванням і не обговорює щоразу заново. Автор описує ринок як ранній: практики ще не усталені, а попередня мода на token-maxxing швидко показала слабке місце. Кількість токенів вимірює активність, але не результат.
Що саме має робити пам’ять агента
У матеріалі пам’ять не ототожнюється з контекстним вікном. Йдеться про окрему систему поза моделлю: постійну, доступну для запитів і керовану правилами доступу. Її роль — не просто зберігати історію, а вирішувати, який попередній результат варто знову подати агенту.
- Вона зберігає те, що генеративна модель уже виробила в попередніх циклах і сесіях.
- Вона застосовує role-based access control, щоб пам’ять однієї команди можна було використовувати в межах компанії без витоку того, що не має бути відкритим.
- Вона знаходить попередній зміст за сенсом, а не за точним ключем, тому має спиратися на semantic search.
Для бізнесу тут важлива не технічна мода на векторний пошук, а управління вже оплаченим знанням. Якщо агент щоразу заново виводить відповідь, компанія платить за повторне міркування. Якщо відповідь можна знайти, перевірити й повернути з пам’яті, частина запитів обходиться без дорогої генерації.
Архітектура, яку автор бачить у компаніях
Описаний патерн виглядає так: новий запит спочатку йде в пам’ять, система робить semantic search, потім rerank для вибору найкращого кандидата. Далі легша модель, часто open-weight, відповідає лише на одне питання: чи достатньо ця знайдена відповідь добра, щоб повернути її користувачу без нового звернення до дорожчої генеративної моделі.
Якщо відповідь достатня, агент повертає її з пам’яті. Якщо ні, запит передають сильнішій і дорожчій моделі, отримують нове рішення, повертають його користувачу і зберігають у ту саму пам’ять. За логікою автора, з часом кожна оригінальна відповідь може стати дешевшою відповіддю для схожого майбутнього запиту.
Практично це стосується насамперед компаній, які вже будують агентів для повторюваних робочих процесів: фінансових термінів, внутрішніх процедур, корпоративних відповідей, сценаріїв підтримки чи операційних задач. Але матеріал не дає готового продукту, тарифу або інструкції впровадження. Це архітектурна теза, а не запуск сервісу.
Типи пам’яті й роль людини
Автор окремо застерігає проти уявлення, що пам’ять агента — це просто коротка і довга пам’ять. Зрілі системи, за його очікуванням, матимуть типи пам’яті. У матеріалі наведено два приклади: taxonomic memory для термінів, контрольованого словника й визначень організації; procedural memory для списків дій і послідовностей, тобто знання «як ми це робимо тут».
Ще одна важлива межа: не все, що агент створив, варто зберігати, і не все збережене варто показувати першим. За текстом, найкращі спогади часто з’являються тому, що людина їх додала, відібрала або підняла вище. Тобто для бізнесу це ближче до підтримки бази знань чи документації, ніж до повністю автономної магії.
- У джерелі немає ціни такого підходу.
- Немає дати доступності або запуску конкретного продукту.
- Немає списку постачальників, яким це вже доступно.
- Немає виміряної економії у відсотках чи грошах.